OpenAIは2026年10月16日(公式の更新履歴の日付)、音声APIのGPT-Live向けに、テキストの説明から声を作る「prompt-to-voice」を全API利用者に一般提供したと発表しました。同時に、日本語のHaremaとShidaを含む9つの音声を追加しています。前日の10月15日には、会話中の判断を担うDecisions APIとのネイティブ連携(直接呼び出す仕組み)も発表しました。
この記事の要点
- 日本語の声にHaremaとShidaを追加。APIでの指定名は
haremaとshidaです。 - 追加音声は日本語・ドイツ語・フランス語・ヒンディー語・韓国語の計9種類です。
- prompt-to-voiceは全API利用者に一般提供。声の作成は無料ですが、試聴や音声生成には通常のセッション料金がかかります。
- テキストから作った声は
GPT-Liveで利用でき、組織ごとに最大100個まで作成できます。 - Decisions APIとの連携では、利用者が話している途中やLiveの返答に応じて判断処理を起動できます。
何が発表されたか
| 項目 | 内容 |
|---|---|
| 10月16日 | prompt-to-voiceの一般提供、9音声の追加 |
| 日本語の追加音声 | Harema、Shida |
| 10月15日 | Decisions APIとのネイティブ連携 |
| 更新履歴のモデル表記 | gpt-live-1。連携ではgpt-6-lunaも記載 |
| 関連エンドポイント | /v1/audio/voices、/v1/live/sessions |
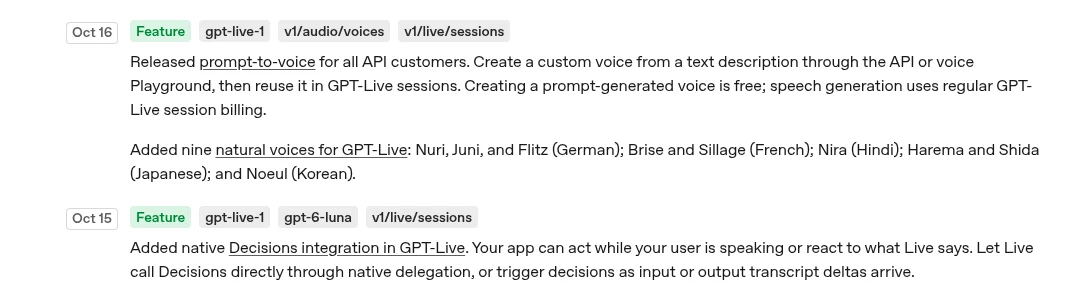
今回の更新は、用意された音声から選ぶ方法、説明文から声を作る方法、音声会話とアプリの判断を結び付ける方法に関するものです。prompt-to-voiceの一般提供はAPI利用者向けの発表です。
日本語のHarema・Shidaを追加、声は開始時に選ぶ
公式の音声一覧では、HaremaとShidaはいずれも言語がJapanese、音声の出自を示す欄がNaturalとされています。声の印象を示すPresentation欄は、HaremaがFeminine(女性的)、ShidaがMasculine(男性的)です。日本語の2音声を含む追加分は、次のとおりです。
| 言語 | 音声名 | APIでの指定名 |
|---|---|---|
| 日本語 | Harema、Shida | harema、shida |
| ドイツ語 | Nuri、Juni、Flitz | nuri、juni、flitz |
| フランス語 | Brise、Sillage | brise、sillage |
| ヒンディー語 | Nira | nira |
| 韓国語 | Noeul | noeul |
既存の音声を選ぶときは、セッションを作成する際にaudio.output.voiceへAPI名を指定します。Haremaを選ぶ場合は"audio": {"output": {"voice": "harema"}}という指定になります。
公式ガイドは、アプリで必要とする言語や発音で声を試すよう案内しています。声は開始時に選択し、別の声を試すには新しいセッションを開始します。
prompt-to-voiceは録音不要、説明文から声を保存
prompt-to-voiceは、声の高さや響き、話す速さなどを文章で説明し、声を作成・保存する機能です。参照用の録音も、同意を示す録音も必要ありません。APIのほか、ブラウザー上の試用画面「voice Playground」から作成できます。
APIでは/v1/audio/voicesにJSONリクエストを送り、typeをpromptにします。公式の作成例には、名前を付けるname、声の説明を記すprompt、autoを指定したmodelが含まれています。
| 指定・保存するもの | 役割と注意点 |
|---|---|
prompt |
声の特徴を文章で説明 |
script_hint |
任意の発話例。最大2,000文字 |
返されるid |
保存した声を再利用するためのID |
session.audio.output.voice.id |
作成した声のIDを指定 |
session.instructions |
会話の指示と元の声の説明を記載 |
script_hintを省略すると、サービスが声の説明から発話用の文章を生成します。自分で指定する場合、空欄や短すぎる文章は受け付けられません。作成成功時の応答にはIDや作成日時、元の説明文などが含まれますが、音声データやプレビューは含まれません。
声の特徴は、アクセント、成人としての年齢の印象、高さ、響き、明瞭さ、速さなどを普通の言葉で記します。これらは独立したAPIパラメーターではなく、説明文に含める内容です。回答の長さや割り込み、処理を委ねるタイミングなどの会話ルールは、セッションの指示に記載します。
作成リクエストが成功するたびに新しい声が保存されます。組織ごとの上限は100個で、アプリが顧客向けに作成する声にも適用されます。同じ声を使い続ける場合は、気に入った声のIDと元の説明文を保存して再利用します。
無料なのは声の作成、試聴は通常料金
テキストから声を作成する操作は無料です。一方、作った声で音声を生成する場合は、通常のGPT-Liveセッション料金が適用されます。Playgroundで声を聴く操作もセッションを動かすため、通常料金の対象です。
| 項目 | 公式ガイドの説明 |
|---|---|
| 声の作成 | テキストからの生成は無料 |
| 試聴・音声生成 | 通常のセッション料金 |
| テキスト生成の声の対応先 | GPT-Live |
| 非対応のAPI | Text to Speech、Realtime、Chat Completions |
| 声の作成時のデータ保持 | Zero Data Retentionには非対応 |
Text to Speech API(文章の読み上げ)、Realtime API(リアルタイムのやり取り)、Chat Completions API(会話応答)では、prompt-to-voiceで作った声は使えません。公式ガイドでは、これらにも対応する録音からのカスタム音声とは区別されています。
Zero Data Retention(データを保持しない設定)については、録音からの作成を含め、/v1/audio/voicesでの声の作成は対応していません。GPT-Liveでの音声生成は、組織やプロジェクトで有効化されている場合に対象となります。その設定では、セッション録音の保存・ダウンロードやセッションの分岐は利用できません。
利用時は成人の声を指定し、特定の人物、有名人、架空のキャラクターの模倣を求めないよう案内されています。子どもの声は認められていません。また、聞き手にAI生成の音声であることを伝え、生成元を示す情報や透かしなどを保持する必要があります。生成した声の独自性は保証されず、ほかの利用者が似た声を作る場合もあります。
Decisions APIとの直接連携で、会話中の判断を起動
10月15日の更新では、GPT-LiveからDecisions APIを直接呼び出せるようになりました。カスタム委譲ではLiveがアプリに通知し、アプリがDecisionsを呼び出します。ネイティブ連携では、このアプリを経由する往復を省きます。
| 判断の起動方法 | 設定と動作 |
|---|---|
| Liveに委ねる | session.delegationで選択肢を設定 |
| 会話の文字起こしに反応 | session.triggersで入力・出力の差分を指定 |
Liveに委ねる方式では、処理を渡すタイミングをセッションの指示に書き、Decisionsには何を選ぶかを質問として設定します。公式例ではgpt-live-1とgpt-6-lunaを使い、車内の温度調整、曇り取り、Responses API(応答生成API)への依頼の要否を、それぞれ判断させています。会話の文字起こしは自動でDecisionsに送られます。
設定には動作するLive接続とapi.decisions.write権限が必要です。通常のLive接続用ヘッダーを使い、Decisions専用のアルファ版ヘッダーは不要です。委譲の種類はセッション作成時に決め、そのセッション中は固定されます。質問は途中でも変更できますが、session.update送信後、対応するsession.updatedを待ってから、その段階の判断用項目を追加します。
判断結果に基づく操作はアプリ側が実行します。公式の車内温度の例では、アプリが温度を上げ、実際の設定を読み戻して確認したうえで、状態をDecisionsに送り、Liveにも結果を返します。直接連携は判断の呼び出しを担い、操作結果の確認も含めたアプリ側の実装が示されています。
利用者・開発者が確かめること
- 日本語のHarema・Shidaを、アプリで必要な言葉や発音で試し、開始時に音声を指定する。
- prompt-to-voiceで作る声の利用先と、試聴・音声生成の課金を確認する。
- 作成した声のIDと説明文を保存し、組織あたり100個の上限を確認する。
- 成人の声の利用、AI生成であることの告知、データ保持設定との対応を確認する。
- Decisions連携の権限と起動方法を設定し、アプリが操作結果を確認してLiveへ返す流れを確認する。
APIの費用を比較する際は、当サイトの主要AIモデルのAPI料金比較も参照できます。