平山 大樹 AB通信 運営責任者
AB通信 編集部が、企業・行政の公式発表や決算資料などの一次情報を確認して書いています。運営会社・編集方針
この記事のポイント
- Google Search Centralは2026年11月11日、CDNに移行した直後にクロールが急増し、一律のボット対策でGooglebotを止めると検索から外れる恐れがあると解説しました
- 応答が速くなると、Googleのクロール速度が上がります。新しいCDNはキャッシュが空のため、初めてのURLはオリジンに届きます
- 公式の対策は3つです。確認済みボットを通す、キャッシュを事前に温める、必要なら一時的に429または503を返す、です
- Googlebotかどうかは、User-Agentだけでは判断せず、逆引きDNSと正引きの確認、または公式のIP範囲で確かめます
- 429や503は、数時間から長くても1〜2日程度の緊急手段です。長く続けると、そのURLが検索から外れる可能性があります
CDNに移行した直後、クロールが急増することがある
Google Search Centralブログは2026年11月11日、「Moving to a CDN without overwhelming your origin (or blocking Googlebot)」を公開し、サイトをCDNの後ろに置くときの注意点を解説しました。投稿者はCherry、Garyらです。同じ内容は、公式動画シリーズ「The Non-Canonical Cabinet」の第5話でも説明されています。
CDNは、コンテンツを利用者の近くにあるエッジサーバーへ配り、表示を速くし、オリジン(元のサーバー)を重いアクセスから守る仕組みです。一方で、切り替えの直後は様子が変わることがあります。公式によると、CDNの導入直後にクローラーのアクセスがほぼすぐに増えた、という声がサイト運営者から届いているそうです。これは、もともと減らしたかった負荷と同じ向きの変化です。
確認した時点では、この公式ブログの日本語版は見当たりませんでした(?hl=jaでも英語の本文でした)。以下は、英語の公式ブログと、日本語がある公式ドキュメントをもとに整理しています。
なぜ、オリジンへのクロールが増えるのか
公式は、この急増を、Googleのクロール基盤がサイトの「クロール能力の上限」(ホスト負荷とも呼ばれます)をどう決めるかと結びつけて説明しています。公式ドキュメント「クロール バジェットの管理」によると、この上限はサーバーに負担をかけすぎないための枠で、並列の接続数と接続時間の両方を見ています。
- 応答が遅くなっていくと、クロール速度は下がります。サーバーを追い込みすぎず、利用者の体験を落とさないためです
- 応答が速く安定していると、クロール速度は上がります。公式は、需要があれば、この上限は徐々に上がると書いています
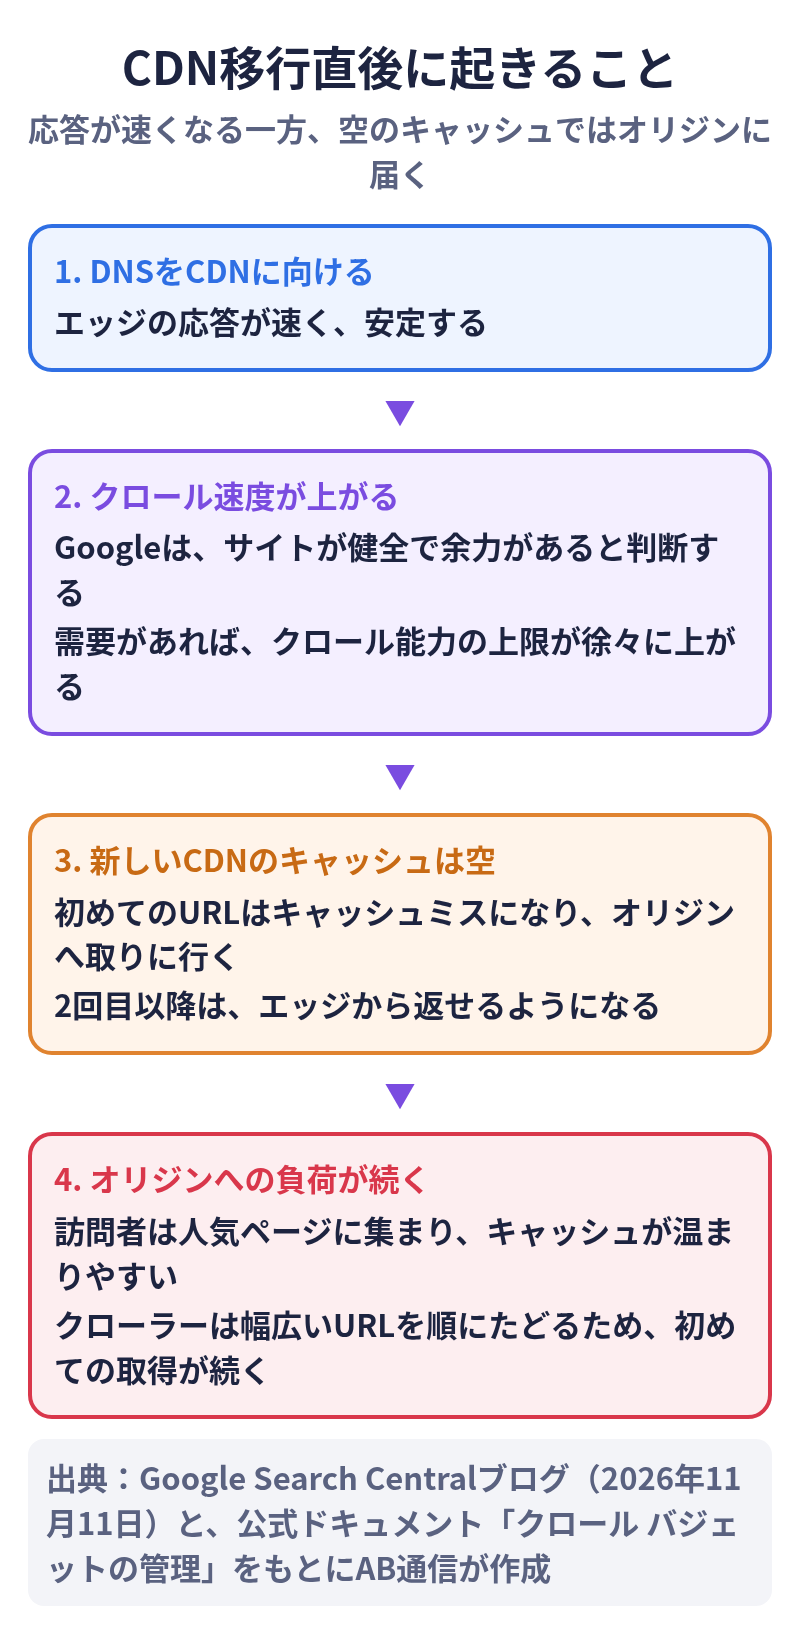
DNSを、応答の速いCDNのエッジに向けると、接続や応答の時間が大きく短くなります。クロールの仕組みから見ると、サーバーの性能が大きく上がったように見えるため、リクエストの間隔をそれに合わせて上げていきます。
ただし、新しいCDNのキャッシュは空(コールド)です。あるエッジで、あるURLが初めて求められると、キャッシュミスになります。エッジはオリジンまで取りに行き、キャッシュできる内容を保管してから、依頼元に返します。同じURLへの2回目以降は、エッジから返せるようになります。
人の訪問は、トップページやよく読まれる記事、キャンペーンページなど、一部の人気ページに集まりやすいため、キャッシュは比較的早く温まります。クローラーはその逆で、サイトにあるURLを幅広く、順にたどります。結果として、次の2つが重なります。
- エッジの速い応答が、クロールを速めてよいという合図になる
- 初めてたどるURLの多くがキャッシュミスになり、そのままオリジンへ届く
公式は、クローラーはすぐには速度を上げ切らず、多くのCDNには接続をならす仕組みもある、と添えています。それでも、エッジのキャッシュが温まるまでは、CDNはまだ盾として十分には働かず、重い処理はオリジン側に残ります。
一律のボット対策で、検索から外れる恐れ
移行直後に、オリジンのログで自動アクセスが急に増えると、管理者は不安になりやすい、と公式は書いています。キャッシュが温まる途中のグラフを見て、CDNの管理画面で一律のボット対策をオンにしたくなる、という流れです。
問題は、例外を設けないルールが、自動化されたアクセスをすべて同じに扱うことです。守りたいクローラーも対象に入ります。CDNやWAFが自動アクセスを検知し、CAPTCHAなどの確認画面を出すと、Googleのクローラーはその確認を通れません。公式は、確認画面や403で遮ると、クローラーは検索に使えないエラーページに留まる、と説明しています。
Googleから見ると、サイトが意図的に制限されている、または壊れているように見えます。この状態が続くと、クローラーは速度を下げ、ページやショッピングの掲載が検索から外れ始める、と公式は警告しています。
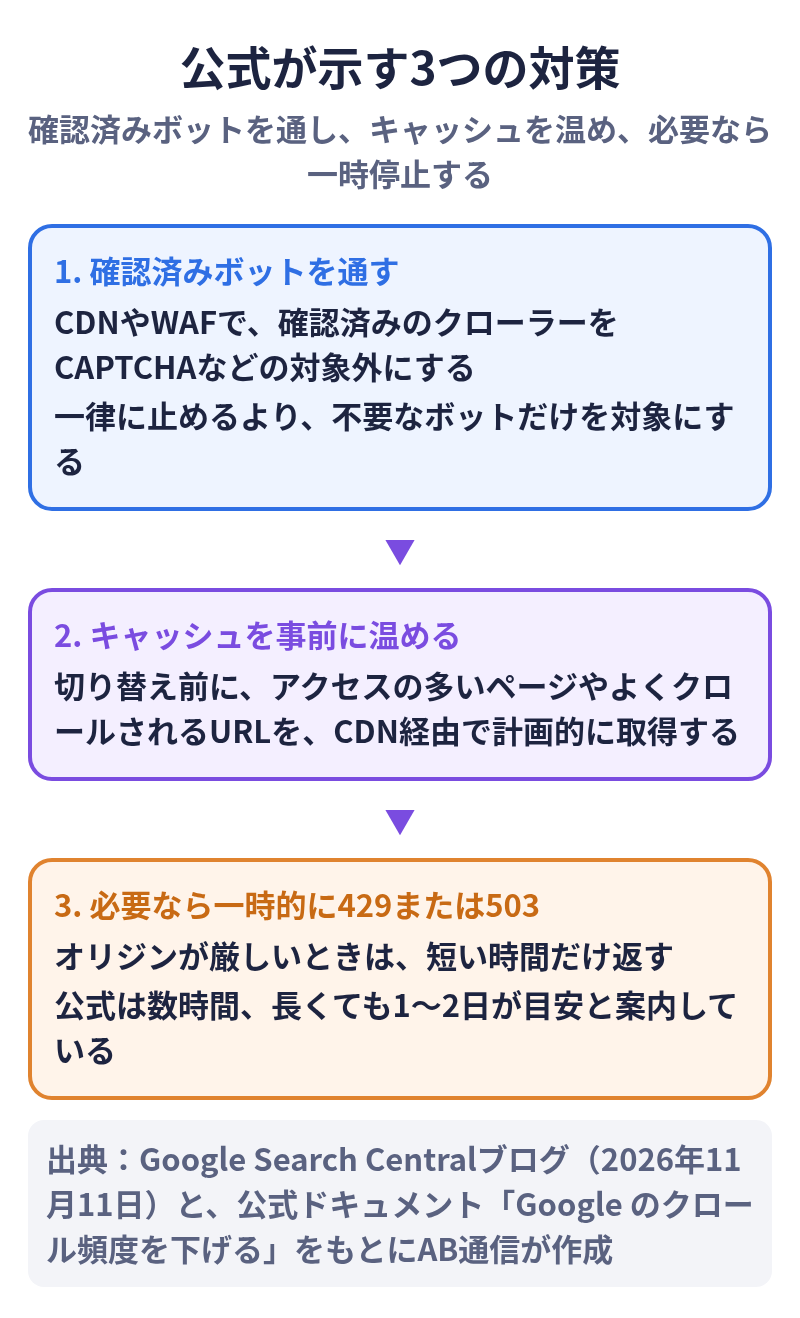
公式が示す3つの対策
公式ブログが挙げる対策は、次の3つです。
1. ボットを止める必要があるなら、確認済みボットを通す
主要なCDNやWAFの多くには、確認済み(known / verified)のボットを通す設定や、管理されたルールがある、と公式は案内しています。これにより、通したいクローラーはCAPTCHAを避け、不要なアクセスは引き続き消せます。クローラーの見分け方としては、Googleが公開しているIP範囲を使う方法が示されています。さらに良い方法として、すべての自動アクセスを止めるのではなく、robots.txtやルールで、不要なボットだけを対象にすることも挙げられています。
2. 切り替えの前に、キャッシュを事前に温める
すべての通信を新しいCDNへ向ける前に、アクセスの多いページ、これから混むと見込まれるページ(キャンペーンや季節の立ち上げなど)、よくクロールされるURLを、CDN経由で計画的に取得し、エッジのキャッシュを先に用意しておく、と公式は書いています。ペースを抑えながら取得する、という点も添えられています。
3. 必要なら、一時的に429または503を返す
キャッシュが温まるまでのあいだ、クロール量がいまだにオリジンの重要な負荷になっているときは、サーバーやCDNのレート制限で、短い時間だけ429(Too Many Requests)または503(Service Unavailable)を返す方法が案内されています。期間の目安は、数時間、長くても1〜2日です。詳細は公式ドキュメント「Google のクロール頻度を下げる」にあります。
Googlebotの確かめ方
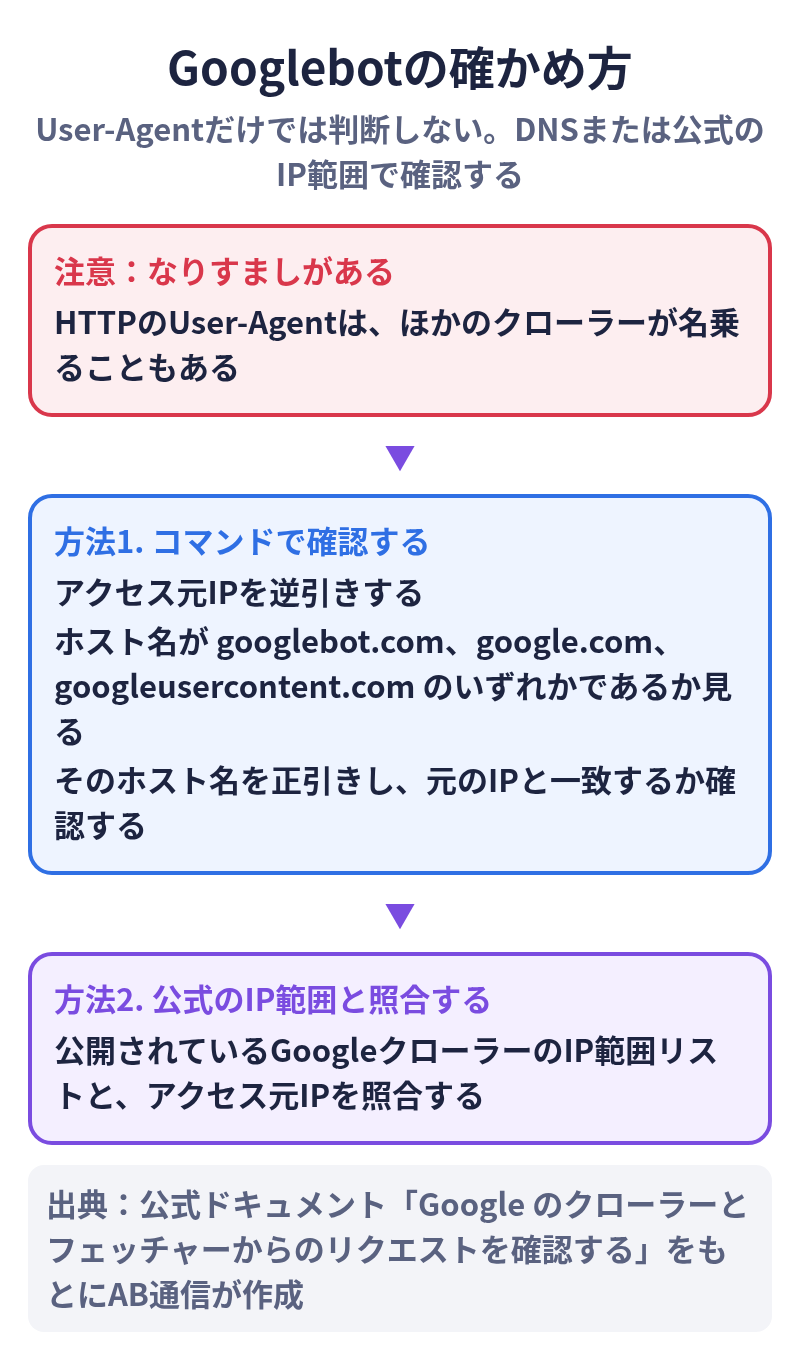
公式ドキュメント「Google のクローラーとフェッチャーからのリクエストを確認する」と、「Googlebot とは」によると、HTTPのUser-Agentはほかのクローラーが名乗ることもあるため、それだけでは判断しません。確かめ方は2つあります。
コマンドで確認する(1件ずつの確認)
- ログに残ったアクセス元IPを、
hostコマンドで逆引きする - ホスト名が
googlebot.com、google.com、googleusercontent.comのいずれかであることを確認する - そのホスト名を正引きし、元のIPと同じであることを確認する
公式の例では、66.249.66.1を逆引きするとcrawl-66-249-66-1.googlebot.comになり、それを正引きすると元のIPに戻ります。地理的なクローラーでは、geo-crawl-….geo.googlebot.comという名前になる例も示されています。
公式のIP範囲と照合する(件数が多いとき)
公開されているGoogleクローラーとフェッチャーのIP範囲リストと、アクセス元IPを照合します。リストはCIDR形式です。Googlebotなどの一般的なクローラー、AdsBotなどの特殊なクローラー、ユーザーの操作で発生するフェッチャー向けのファイルが分けられています。公式ブログも、確認済みボットを通すときに、この公開IP範囲で見分ける方法に触れています。
注意点
- 一律のボット対策やCAPTCHA、
403の壁でGoogleのクローラーを止めると、検索から外れる恐れがあります 429や503は、短い緊急手段です。公式の緊急時ガイドでは、500も同じ目的で使えると書かれています。これらの応答が多いと、ホスト名全体のクロール頻度が下がります。エラーが減ると、頻度は自動で戻ります- 1〜2日を超えて使い続けることは、公式は推奨していません。同じURLで数日続くと、そのURLがインデックスから削除される場合があります
503または429を返すときは、Retry-Afterヘッダーで、再試行してよい時期を秒数またはUTCの日時で示すこともできます- クロール頻度を下げると、新しいページの発見が減り、既存ページの更新が遅くなり、削除したページがインデックスに残る時間が長くなる、といった影響が出ます。Google広告では、キャンペーンが止まるなどの影響もあり得ます
- エラー応答が難しい場合は、公式の特別なリクエストで、異常に高いクロール頻度を報告できます。頻度を上げてほしいという依頼はできず、審査と処理には数日かかることがあります
- どのCDNやWAFの、どの画面で確認済みボットを通すかといった、製品ごとの操作手順は、今回の公式ブログには記載がありません
出典
- Google Search Centralブログ「Moving to a CDN without overwhelming your origin (or blocking Googlebot)」(2026年11月11日)
- Google Search Central公式YouTube「Moved to a CDN: Why Is Everything Crawling Everywhere All at Once?」(The Non-Canonical Cabinet 第5話)
- 公式ドキュメント「クロール バジェットの管理」
- 公式ドキュメント「Google のクロール頻度を下げる」
- 公式ドキュメント「Google のクローラーとフェッチャーからのリクエストを確認する」
- 公式ドキュメント「Googlebot とは」
更新履歴
- 2026年11月12日:初版