
平山 大樹 AB通信 運営責任者
AB通信 編集部が、企業・行政の公式発表や決算資料などの一次情報を確認して書いています。運営会社・編集方針
この記事のポイント
- OpenAIは2026年11月19日、ChatGPTの速度低下をCodexエージェントが自動で調べ、修正案を出す社内の仕組み「Performance Factory」を公式ブログで解説しました
- 最初のワークフロー「Regression Workflow」は、性能のアラートをきっかけに調査し、原因を特定し、修正のプルリクエストを出し、本番反映のあとに回復したかを確認します
- 公式によると、3か月強で1,700件を超える調査を追跡し、600件超の原因を特定しました(1日あたり17件の自動調査)。原因案100件を人手で確認したところ、70%を正確と評価しています
- 修正をマージするかは、エンジニアが判断します。これは一般向けの新機能や設定項目ではなく、OpenAI社内の開発・運用基盤の事例です
- 表示速度やAPI応答の低下に気づきにくいWebサービス、EC、SaaSの現場でも、「夜間に調査と修正案を用意し、朝にエンジニアが確認して反映する」という進め方の参考になります
OpenAIが、ChatGPTを速く保つ社内の仕組みを公開
OpenAIは2026年11月19日、公式ブログ「How OpenAI’s Performance Factory keeps ChatGPT fast」で、ChatGPTの速度低下を調べて直す社内の仕組み「Performance Factory」を解説しました。著者は、Technical StaffのOkay Zed氏とCyrus Forbes氏です。
Performance Factoryは、クラウド上で動き、OpenAIのコーディングエージェント「Codex」とモデルを使って、性能のリグレッション(以前より遅くなった、劣化した状態)の調査と対応を自動化するシステムです。エンジニアが、繰り返し発生する作業向けのワークフローを定義し、Codexエージェントへの指示を書きます。
ここで先に押さえておきたいのは、これがChatGPTの画面に新しく追加される機能や、利用者がオンにできる設定ではない、という点です。OpenAIが自社のサービスを速く保つために作った、社内の開発・運用基盤の事例です。ChatGPT側の利用者向けの更新内容は、AB通信の「ChatGPTの最新アップデート・更新履歴」でもまとめています。
Performance Factoryの構成
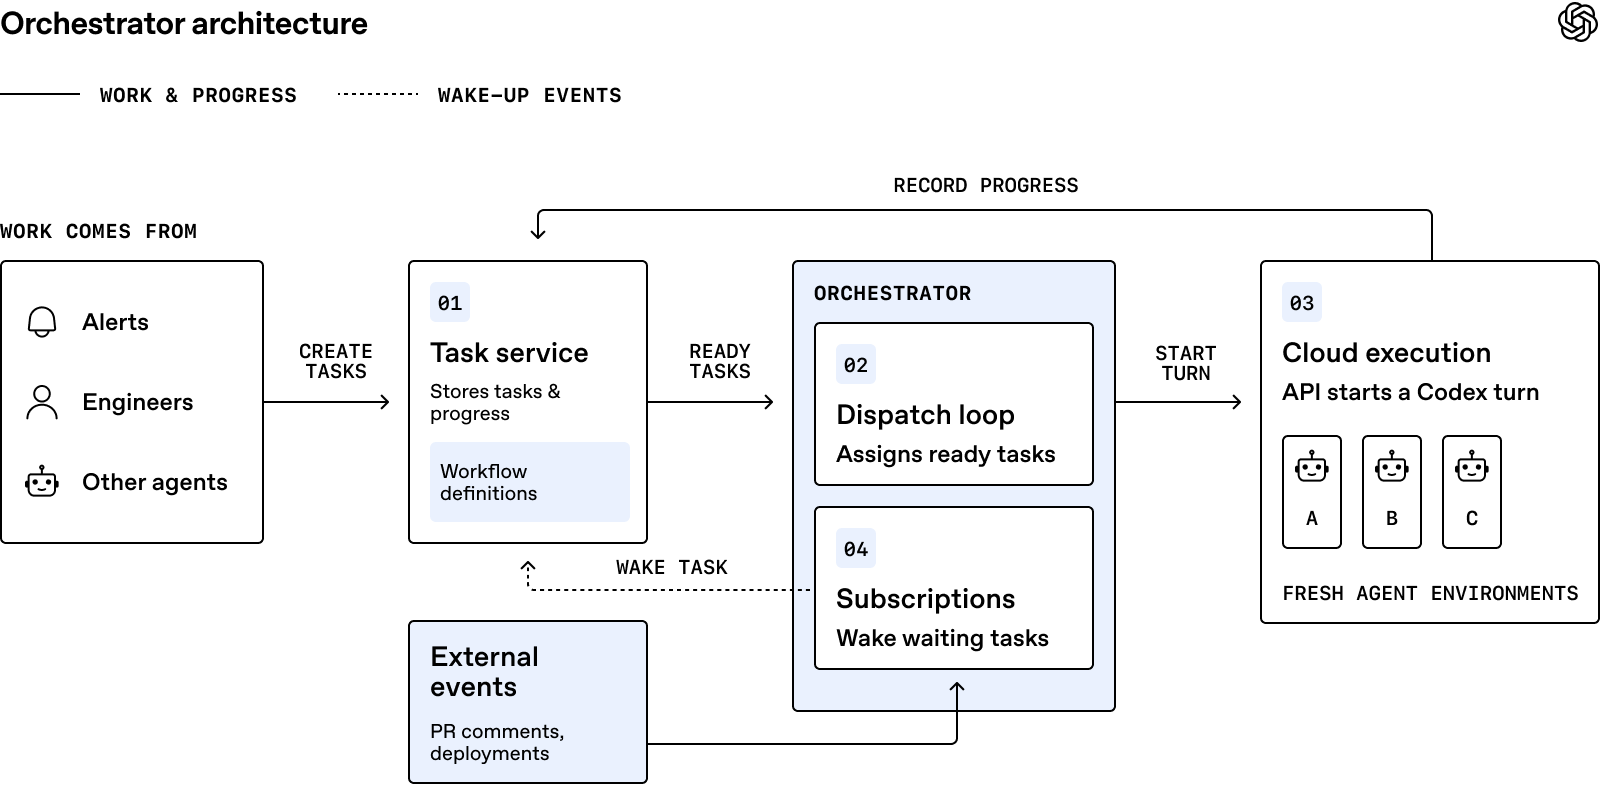
公式ブログによると、Performance Factoryは次の4つで構成されています。
- 設定可能なワークフローを持つタスク管理
- 準備ができた作業をエージェントに割り当てるディスパッチループ
- クラウド上でCodexを動かすAPI
- 状況の変化(GitHubのレビューコメントやデプロイの完了など)で、待ち状態のエージェントを起こすサブスクリプション
エンジニアは、ワークフローの設定ファイルと、各工程でエージェントが従うMarkdownの指示を書きます。設定には、タスクが取りうる状態、遷移のルール、エンジニアの判断が必要な工程が含まれます。作業はワークフロー上のタスクになり、状態と調査結果はタスク側に残るため、別のエージェントやエンジニアが途中から引き継げます。
Codexは、OpenAIのネットワーク内の環境で動きます。コードリポジトリに加え、エンジニアが使う監視の仕組み(メトリクス、ログ、トレース、CPUプロファイル、メモリのスナップショット)にもアクセスできます。エージェントはサービス用の識別情報(service identity)で動くため、権限の範囲を絞り、どの操作が性能調査のエージェントによるものかを追えます。クラウドに移したことで、エンジニアのパソコンが開いているかどうかに頼らず、並行して調査を進められる、と公式は説明しています。
最初のワークフロー:速度低下の検知から回復確認まで
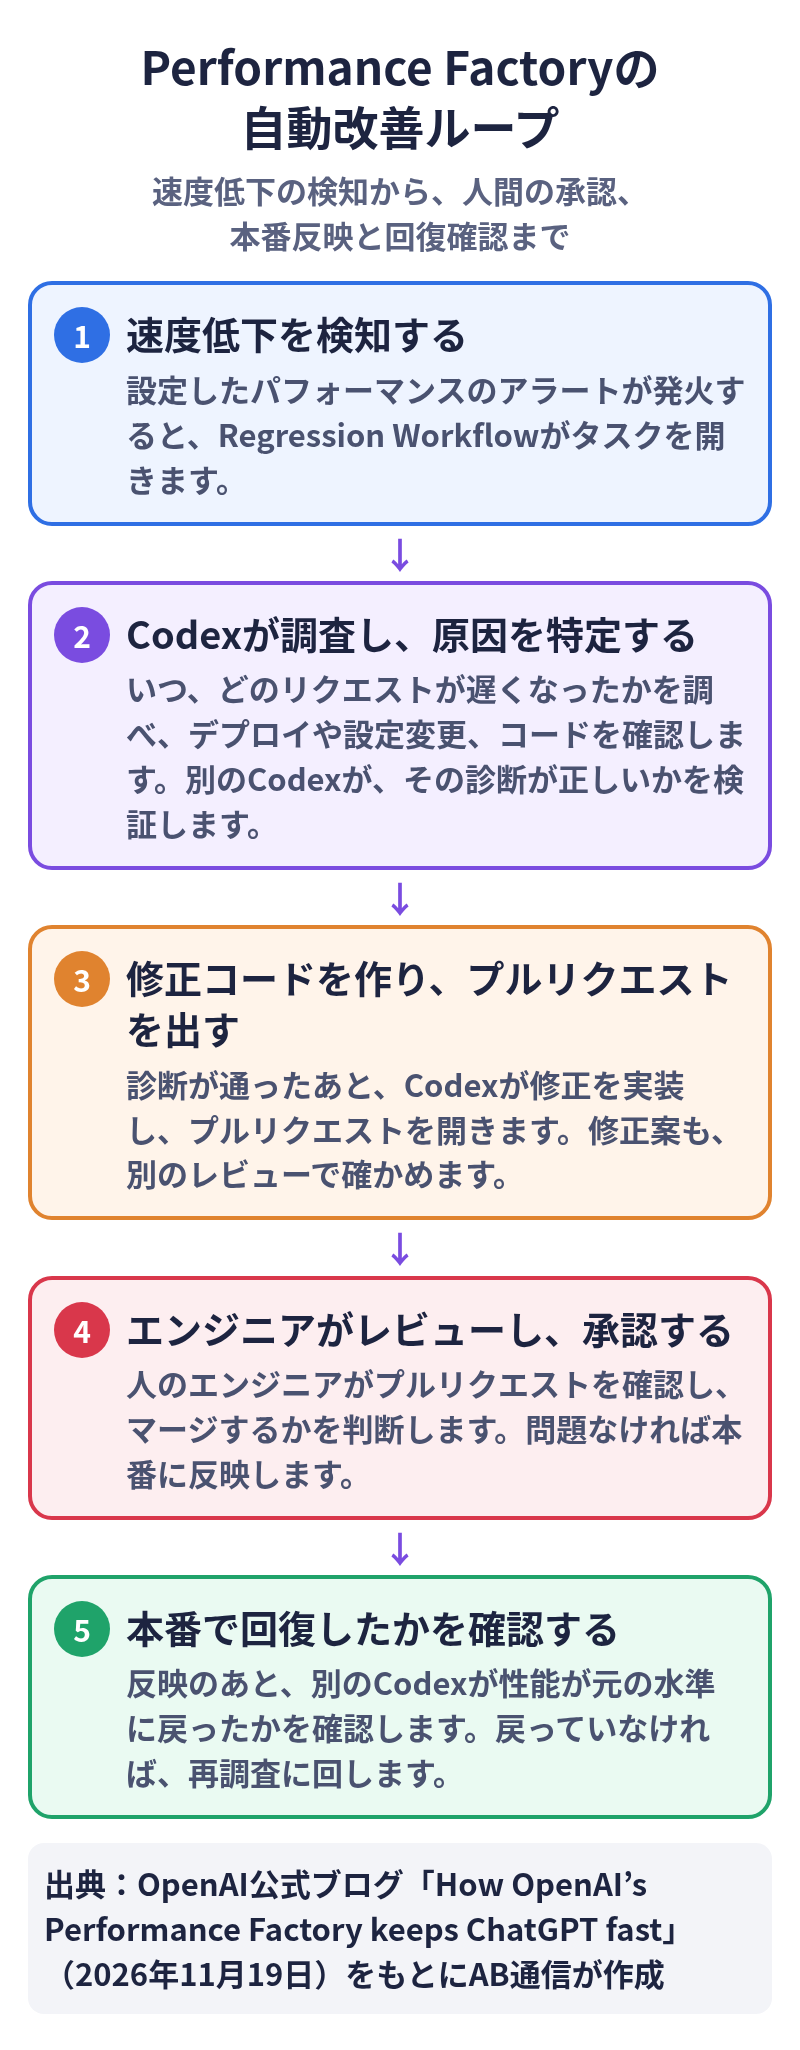
Performance Factoryで最初に動かしているのが、「Regression Workflow」です。性能のリグレッションは、「調査が必要」「原因を特定した」「修正案を出した」「解決した」といった段階を経ます。ワークフローも、同じ段階に沿ってタスクを進める形になっています。
設定したパフォーマンスのアラートが発火すると、ワークフローがタスクを開きます。エージェントが調査結果をタスクに記録し、修正案を出します。エンジニアはSlackや専用の画面で進捗を追い、文脈を足したり、提案された変更を確認したりできます。修正が本番に出たあと、別のエージェントが同じタスクを受け取り、性能が元の水準に戻ったかを確認します。
手作業の調査から、工場のような自動化へ
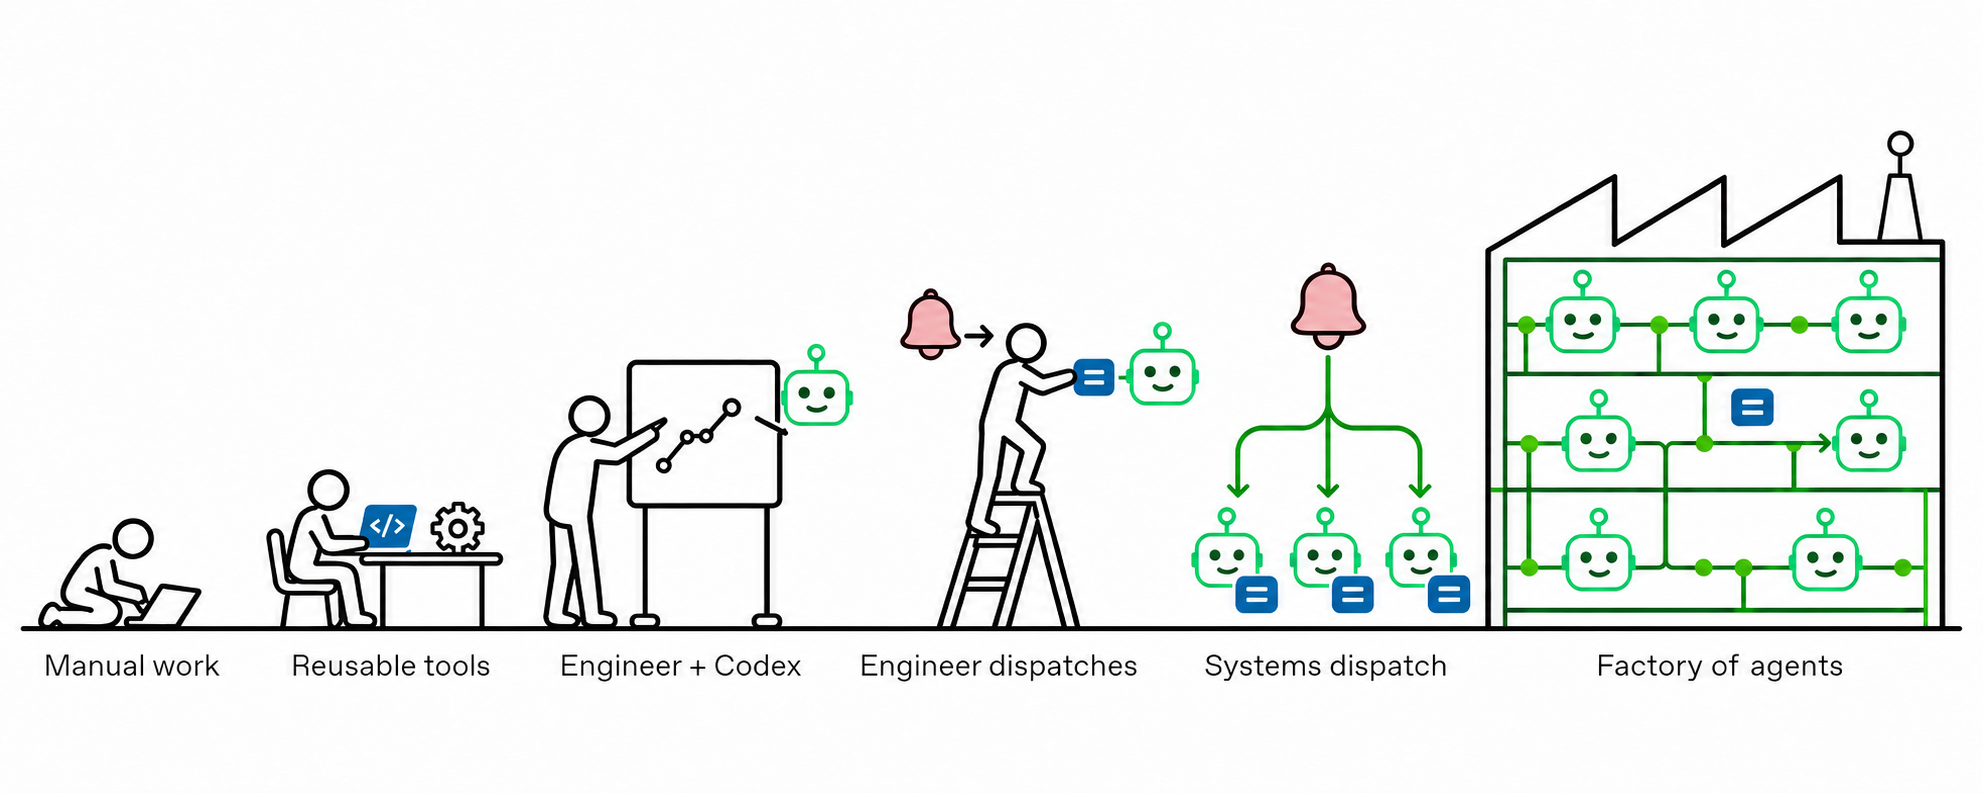
公式ブログでは、チームの進め方が次のように変わってきた、と整理しています。Codexの導入前は、エンジニアがメトリクスやログ、トレース、コードを手で見て、遅くなった原因を調べていました。同じ種類の問題(たとえば、ChatGPTの最初のトークンが出るまでの時間の悪化)が繰り返されると、CPUやメモリ確保のプロファイラなど、調査を助けるツールを増やしていき、性能ツールは30を超えた、としています。
Codexを相棒として使う段階では、「なぜ遅くなったのか」と頼むと、大きなコードベースの検索や、関連するメトリクス・トレースの確認、サービスをまたいだ追跡がしやすくなりました。ただし、どのツールを使うか、調査をどう進めるかは、まだエンジニアが舵を取る必要がありました。
その後、調査の手順を「perf-forensics」という共有のスキルにまとめました。使えるツール、使うタイミング、遅くなったときのこなし方が書かれており、Codexは次のような角度から調べます。
- 遅くなり始めた時点を見つける
- 影響を受けたリクエストを特定する
- デプロイや設定変更で説明できるかを調べる
公式によると、過去のリグレッションをもとにした評価で、このスキルを繰り返し直しています。対象にした種類の問題(ChatGPTのレイテンシや可用性の低下など)では、アラートを渡すだけで、工程を一つずつ案内しなくても診断が返ってくるようになった、としています。
その後は、アラートをCodexに貼り付け、結果をSlackに戻す作業が残る「人の中継」の段階、アラートからクラウド上のCodex調査までが自動で始まり、結果がSlackに投稿される段階を経て、いまのPerformance Factoryに至ります。工場の段階では、各タスクが次に何を必要としているかを追い、準備ができた工程にエージェントを割り当てます。よくある最適化は、サービス横断で定期的に回すワークフローにもできます。
原因調査と、誤った診断を防ぐ仕組み
原因の特定が、ワークフローの最初の大きな工程です。エージェントは、どの指標が悪化したか、いつ変わり始めたか、どのリクエストが影響を受けたかを調べます。アラートは閾値を超えたときに発火しますが、実際の悪化は何時間も前から始まっていることがあります。そのため、エージェントはデータをさかのぼって、指標が悪化し始めた時点を探します。
そのうえで、リクエストの集団を比較します。似たリクエスト自体が遅くなったのか、もともと遅かったリクエストの割合が増えただけなのかで、原因の見通しが変わるためです。時点と範囲が分かると、デプロイやフィーチャーフラグの変更を確認し、関連するコードを読み、その変更が影響を受けたリクエストに届いたタイミングと、ログやトレースで説明できるかを検証します。
初期には、エージェントが最初に思いついた説明で止まってしまい、あとから誤っていた例もあった、と公式は書いています。これを減らすため、「adversarial review(対立的な検証)」を入れました。診断を出したセッションとは別のCodexが、その診断を否定できないかを試します。前提を見直し、「その変更が原因なら、変更が当たっていない似たリクエストは健全なままか」「疑わしい変更を戻したら、指標は回復したか」といった反対の見方も確認します。
公式が挙げた例では、あるエージェントが、失敗したChatGPTの会話を画像ダウンロードのエラーに結び付け、「原因は分かった」としました。検証役のCodexは、ファイルの場所を特定する内部サービスはすでに回復していたのに、画像リクエストの失敗は続いていた、と指摘しました。その診断では続きの失敗を説明できなかったため、調査は再開されています。
大きな仕事を、焦点を絞ったCodexの工程に分けるのは効果があった、と公式は述べています。原因の提案100件を人手で確認したところ、70%を正確と評価し、残りの30%は追加の整理が必要だったか、因果関係を十分に示せていなかった、としています。Regression Workflowでは、調査、診断への検証、修正案の作成を別の工程に分けることで、精度を上げようとしています。
修正案の作成と、人が承認する工程
診断が検証を通過すると、ワークフローはCodexに修正の実装とプルリクエストの作成を依頼します。エンジニアがプルリクエストを確認し、マージするかを判断します。各タスクには、リグレッションの概要、影響、原因、修正案を自動でまとめた報告書が付きます。指標の時系列、CPUのフレームグラフ、トレースなど、根拠をすぐ見られるように整えている、と公式は説明しています。
エンジニアは、提案されたプルリクエストを直接直すことも、診断を材料に自分で修正を書くこともできます。プルリクエストにコメントを残すと、ワークフローがエージェントを起こし、対応させます。
エンジニアが修正を本番に出したあと、ワークフローはエージェントを起こし、性能が以前の基準に戻ったかを確認します。戻っていれば、タスクは解決になります。一部だけ戻った場合は、元のリグレッションを解決扱いにし、残っている遅れ(原因が違う可能性がある)向けに新しいタスクを開きます。改善がなければ、結果を記録して、再調査に戻します。
公式は、原因を見つけることより、修正を正しく仕上げることのほうが難しい、と書いています。エージェントが出す変更が必要以上に複雑だったり、新しい問題を持ち込んだりする例もあったため、修正案にも対立的な検証を入れ、原因に対しているか、副作用がないかを確認しています。キャッシュを足すと速くなる一方で、古いデータを出すリスクが出る、といった判断は、そのサービスを知るエンジニアの判断が必要だ、とも述べています。
いまは、エージェントが提案した修正と、エンジニアが最終的にマージした内容を比べて、提案の足りない点を学び、評価と改善のループを作っている段階です。修正案をエンジニアに渡す前に、合成の性能テストで効果を測って直す仕組みも準備中、としています。リスクの低い変更については、将来的に人を介さず出荷できないかも検討している、と公式は書いています。現時点では、修正の反映をエンジニアが承認する工程が残っています。公式も、「いまのボトルネックは、エンジニアが修正を確認してマージする待ち時間かもしれない」と述べています。
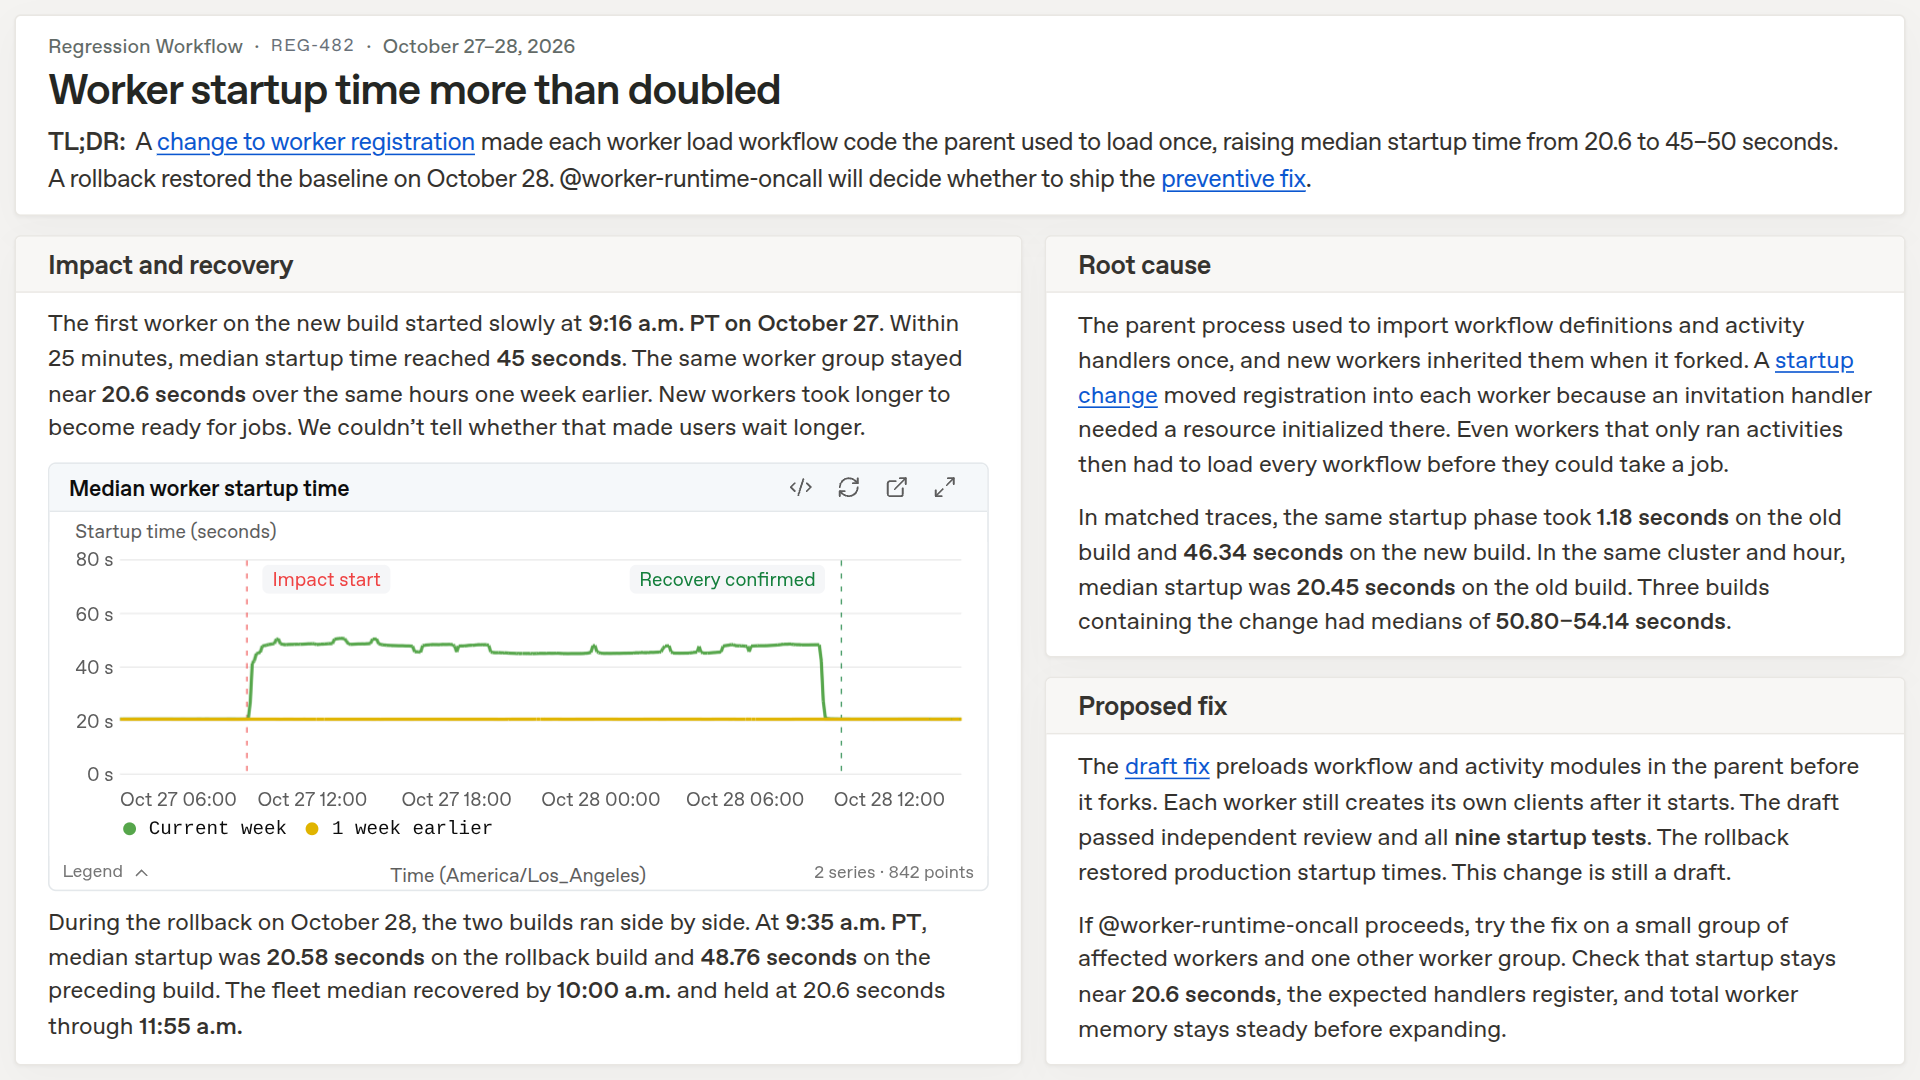
公式の例では、2026年10月27日から28日の案件「REG-482」が取り上げられています。ワーカーの登録方法を変えた結果、各ワーカーが以前は親プロセスで一度だけ読んでいたワークフローのコードを読むようになり、起動時間の中央値が20.6秒から45〜50秒に延びた、という内容です。10月28日のロールバックで基準値に戻っています。再発を防ぐ修正案は下書きで、担当チームが出荷するかを判断する、と報告書に書かれています。自動で調査と修正案まで進めても、最終的な反映は人が決める、といういまの役割分担がよく分かる例です。
公式が示した成果
Regression Workflowについて、公式ブログが示している数字は次のとおりです。
- 3か月強で、1,700件を超える調査を追跡し、600件超の原因を特定した
- 1日あたり17件の自動調査に相当する
- 原因の提案100件を人手で確認し、70%を正確と評価した。残りの30%は、追加の整理が必要だったか、因果関係を十分に示せていなかった
これらは公式ブログに書かれた数字です。修正がどれだけ採用されたか、ChatGPT全体の応答速度が何ミリ秒改善したかなど、それ以上の効果の数値は、この記事では公式に示されていません。
日本のWebサービス、EC、SaaSの現場で考えると
繰り返しになりますが、Performance Factoryは、日本の事業者がChatGPTの設定画面から使える商品ではありません。一方で、公式が「ほかのサービスチームにも、エージェントを使ったワークフローの参考にしてほしい」と述べている通り、速さの劣化に気づきにくく、原因調査に時間がかかる現場には、考え方として学べる点があります。
たとえば、自社サイトの表示速度の低下は、Core Web Vitals(LCPなど)の悪化として後から数字に出ても、夜間やリリース直後には気づきにくいことがあります。ECの商品詳細、申し込みフォーム、検索APIのように、応答が数百ミリ秒遅れるだけで離脱やコンバージョンに影響する箇所でも、同じことが起きます。SaaSであれば、管理画面や外部向けAPIのレイテンシ悪化が、サポート問い合わせより先にユーザー体験を静かに落とすこともあります。
OpenAIの事例を、こうした現場の一日に置き換えると、次のような流れになります。リリース後や夜間に、性能のアラートをきっかけにプロファイルやログ、トレースを自動で集め、原因の見当と修正のプルリクエスト下書きまで用意する。朝、エンジニアが報告書と根拠のグラフを確認し、問題なければマージして本番に出す。出したあとは、基準値に戻ったかを自動で確認し、戻っていなければ再調査に回す、という分担です。
そのまま同じ仕組みを自社に置く必要はありません。現場で取り入れやすいのは、次のような設計の考え方です。
- 「遅いかもしれない」ではなく、監視の閾値を超えたら調査タスクが自動で開くようにする
- 調査の手順(いつから遅いか、どのリクエストか、直前のデプロイや設定変更か)を、属人的な勘に頼らず手順として残す
- 最初の説明をそのまま信じず、別の目で否定できないかを確かめる
- 修正案の作成まで自動化しても、マージと本番反映は人が承認する
- 反映後に、元の水準へ戻ったかを必ず確認する。一部しか戻らなければ、残りの遅れは別件として扱う
公式は、エンジニアの注意を守ることも強調しています。エージェントの調査結果は、そのままでは長い文章になりやすく、何を主張しているのか、どのグラフが根拠なのかを読み解くだけで時間がかかる、としています。調査そのものは人より多く回せても、どれを読むかを人が選ばなければならない状態では、負荷は残り続けます。いまのワークフローでは、関連するインシデントを結び、チームが気にする指標ごとにまとめ、影響の大きさで並べることで、エンジニアは判断とトレードオフの検討に時間を使えるようにしている、と説明しています。
すでにCodexなどのコーディングエージェントを使っている開発チームであれば、「障害の一次切り分けと修正の下書きまではエージェント、マージは人」という役割分担を、性能のリグレッションにも広げる、というのが、この事例の実務的な読み方です。完全な自動修復がいまの到達点ではない、という点も、公式の記述どおりに見ておく必要があります。
公式が見据える次の段階
Regression Workflowは、状態を明確に分けてタスクを進める「エージェント工場」の一つの例です。公式は、同じ仕組みを別のワークフローでも使い、一方のワークフローが他方のタスクを開く形にもできる、としています。公式ブログには、アラート対応、リグレッション調査、サービス監視のタスクをエージェントが進め、別のワークフローへ仕事を渡す様子を示す動画も掲載されています。
いまのRegression Workflowはアラートの発火から始まりますが、OpenAIは、アラートがまだ出ていない段階でも、遅れや改善余地を見つける方法を準備中だとしています。すでに集めている細かい性能データ(リリースをまたいだCPU・メモリのプロファイル、ヒープダンプ、リクエストのトレースなど)を比べ、アラートでは拾いきれない悪化や、最適化の余地に気づけるようにしたい、という方針です。
原因の見つけ方がすでに分かっている問題については、別のワークフローにも落とし込もうとしています。例として挙げられているのが、サービスを適正規模にするスキルです。必要以上のレプリカを起こし続けるオートスケール設定を見つける、といったパターンを、全サービスで定期的に回したい、としています。ある遅れからエンジニアが学んだことを、数か月後の別サービスでの調査や修正にも活かせる状態を目指しています。
公式ブログの結びは、「次にChatGPTが遅くなったと感じたとき、Performance Factoryがすでに理由を調べている可能性は高い」というものです。Codexは、ChatGPTをより速く作る助けになってきた。いまは、ChatGPTを速く保つ助けにもなっている、と述べています。
出典
- OpenAI「How OpenAI’s Performance Factory keeps ChatGPT fast」(2026年11月19日)
- OpenAI Newsroom(Engineering)
- OpenAI「How OpenAI uses Codex」(2026年1月14日、性能改善へのCodex活用にも言及)