
平山 大樹 AB通信 運営責任者
AB通信 編集部が、企業・行政の公式発表や決算資料などの一次情報を確認して書いています。運営会社・編集方針
この記事のポイント
- OpenAIは2026年11月20日付の公式記事で、不正な蒸留(adversarial distillation)への対策を公表しました。公式X(@OpenAI)でも、日本時間2026年11月21日4時33分ごろに同じ内容を案内しています
- 蒸留とは、あるモデル(教師)の出力や推論を使って、別のモデル(生徒)を学習させる手法です。公式は、許可なく出力を使って似た能力のモデルを作り、元と同程度の安全対策なしで使うことを、不正な蒸留として説明しています
- 保護された推論(モデルが答えを出す途中で内部に残す思考過程)の取り出しについて、公式の内部評価では、以前のリクエストからの抽出成功率が、当初の対策を付けたGPT-6 Astraの54.0%から、更新後の対策を付けたGPT-6.2 Astraの0.2%に下がりました。今回のリクエストからの抽出は22.9%から0.9%です。いずれも6つの攻撃側モデルの平均です
- 対策は、リクエスト単位(モデルの振る舞い、分類器、APIの制限)と、キャンペーン単位(調査と執行)の二層です。公式によると、こうしたキャンペーンへの週次の執行は、数千から数万アカウントの規模で、今夏は件数が大きく増えたとしています
- 利用ポリシー(2026年11月20日施行)では、OpenAIの代替となるモデル向けに、出力を学習データや評価の信号として使うこと、保護された推論を不正に取り出そうとすることを禁じています。研究やソフト開発、評価、製品開発は、その範囲内で認められています
OpenAIが、不正な蒸留への対策を公表
OpenAIは2026年11月20日付の公式記事「Combatting adversarial distillation」で、モデルの能力を許可なく別のモデルへ移す「不正な蒸留(adversarial distillation)」への対策を公表しました。公式X(@OpenAI)でも、日本時間2026年11月21日4時33分ごろ、同じ内容を案内しています。
公式の説明では、最先端のAIモデルが強くなるほど、安全対策の役割も大きくなります。不正な蒸留は、悪意のある主体が、その能力を適切な対策なしで再現する道になり得ます。たとえば、サイバー分野の能力を別のモデルへ移し、元のモデルなら拒否したり、対策で止めたりするような使い方に転用する、といった例が挙げられています。
今回の発表の対象として、公式が特に名前を挙げているのは、GPT-6.2 AstraとGPT-6.2 Solです。保護された推論(protected reasoning)の取り出しへの防御を、この2つのモデルで強めたとしています。ChatGPT側の動きは、ChatGPTの更新履歴でも追えます。
蒸留とは何か、なぜ安全上の問題になるのか
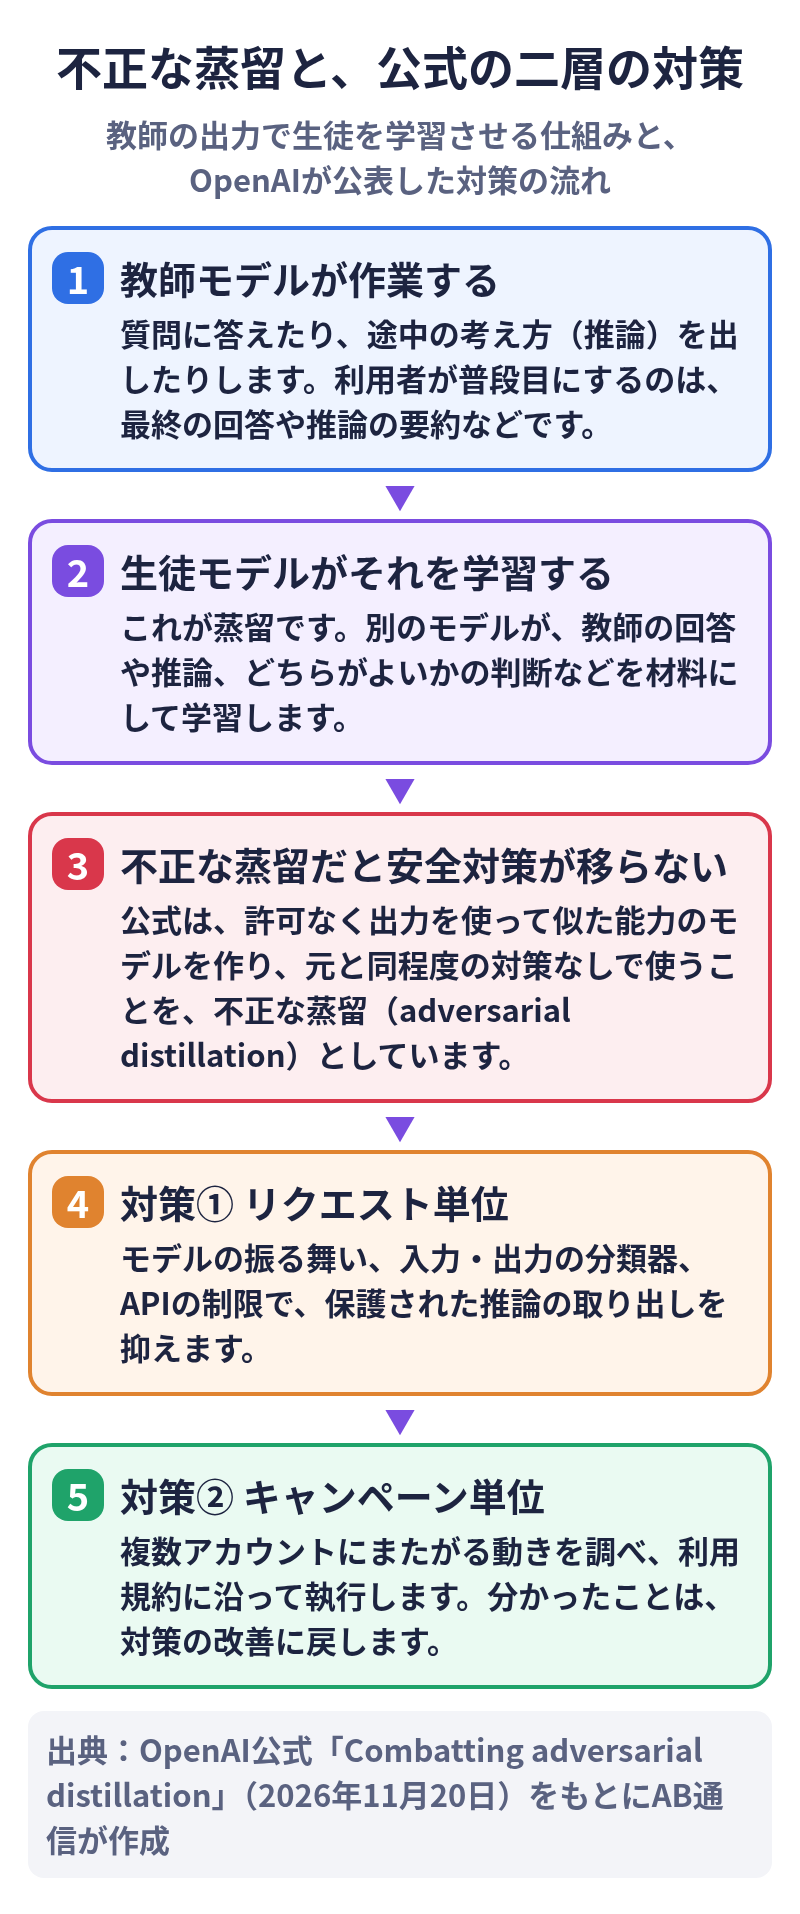
蒸留は、機械学習ではよく使われる手法です。あるモデル(教師)が出したデータを、別のモデル(生徒)が学習します。公式が例に挙げている材料は、教師の回答、推論、そして「どの答えがよいか、なぜよいか」の判断です。
知的財産の問題だけでなく、許可のない蒸留は安全上の大きなリスクになると、公式は書いています。不正な蒸留を通ると、2つ目のモデルは、最先端の能力を学べても、元のモデルが「その能力をどう使ってよいか」を決めていた安全対策までは引き継がない、という整理です。
懸念がはっきり出やすい領域として、公式はサイバーセキュリティと生物学を挙げています。防御のための脆弱性調査を助けるモデルは、攻撃側の作業にも転用し得る。研究を助けるモデルも、有害な使い方に転用し得る、という説明です。能力だけが、より弱い対策のモデルへ移ると、元のモデルなら拒否したり、対策で止めたりする支援をしてしまう恐れがある、としています。
正確な推論過程を守る理由
公式が特に重視しているのは、保護された推論の取り出しを防ぐことです。保護された推論とは、モデルが答えにたどり着くまでに内部で踏む途中経過(chain-of-thought)です。最終の回答には出てこない情報が含まれることがあり、別のモデルを学習させる材料として価値が高い、と説明されています。
OpenAIのモデルは、プログラミングや防御的なサイバーセキュリティの作業を助ける、と公式は書いています。その種の、利用ポリシーで認められた作業の出力を大量に学習した2つ目のモデルでも、攻撃的な作業に使える技能を学んでしまう可能性がある、というのが今回の問題意識です。公式は、蒸留、とくに推論の過程を材料にした場合に、リスクのあるサイバー能力がどれだけ移るかを内部で調べたとしています。
内部研究では、利用者が普段目にする内容(最終の回答、推論の要約、ツールとのやり取り)を蒸留の基準にし、教師の正確な推論過程まで生徒が使えると、サイバー能力がどれだけ上積みされるかを比べました。学習は同じ事前学習済みの生徒モデルから始め、主にAstra級の教師が、プログラミングと防御的なサイバーの作業で残した軌跡を使っています。各生徒は、教師ありの微調整のあとと、サイバーとプログラミングの環境で軽い強化学習を行ったあとの2回、評価されています。
公式の結果では、教師ありの微調整のあとでは、正確な推論過程で学習した生徒の方が、推論の要約で学習した生徒より概して良い成績でした。強化学習のあとも、評価時の推論予算がいちばん大きい条件では、正確な推論過程で学習した生徒の方が、示された両方のベンチマークで高い得点でした。一方、予算が小さい条件では、要約で学習した生徒の方が高い得点だった、と書かれています。
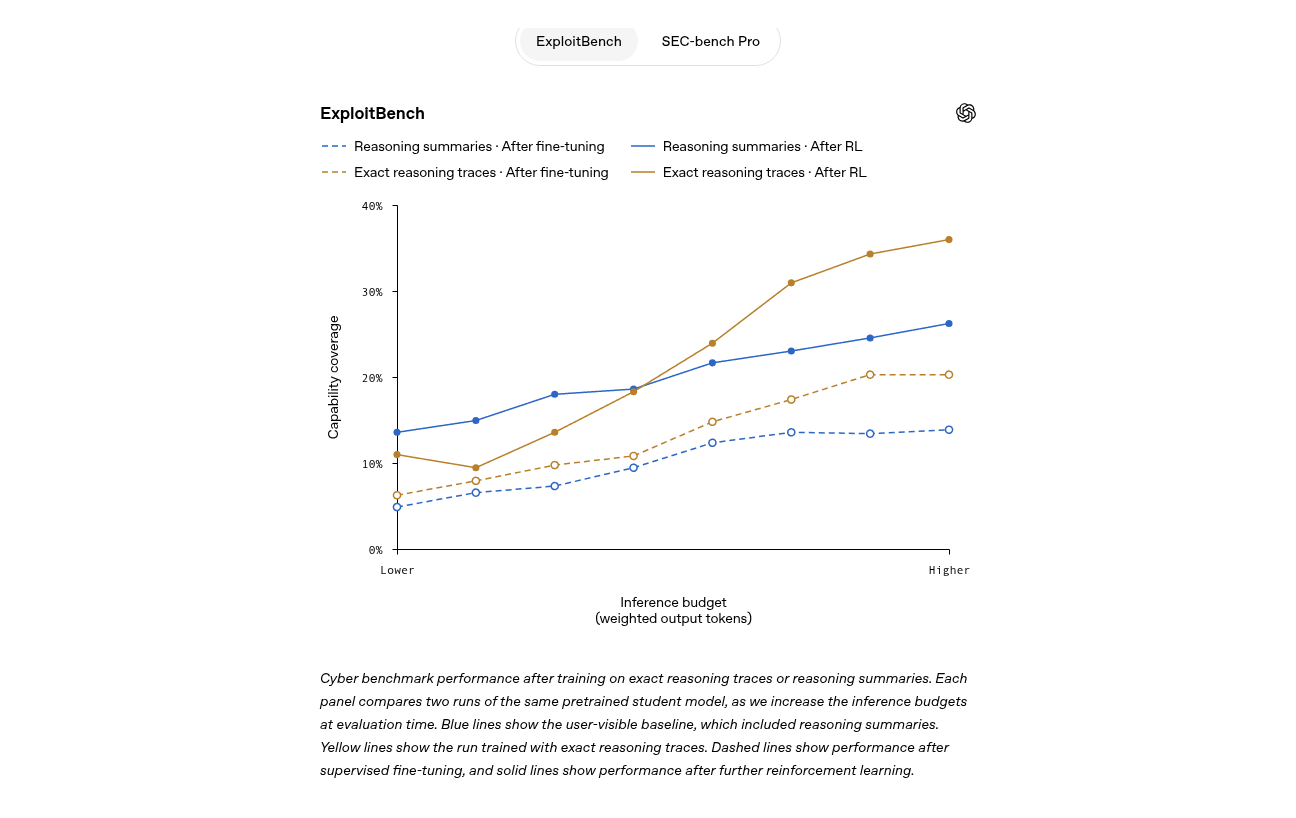
公式は、この結果から、推論の過程を守ることが、利用ポリシーで認められた作業でも、サイバー能力の移転を抑え得ると述べています。正確な推論過程は、教師が元々こなした作業の枠を超えて、生徒に技能を教え得る、という整理です。公式ページには「SEC-bench Pro」の切り替えもありますが、本記事では公式が最初に示しているExploitBenchの図だけを掲載します。数値の読み取りは、公式の本文の説明の範囲にとどめています。
対策は、リクエスト単位とキャンペーン単位の二層
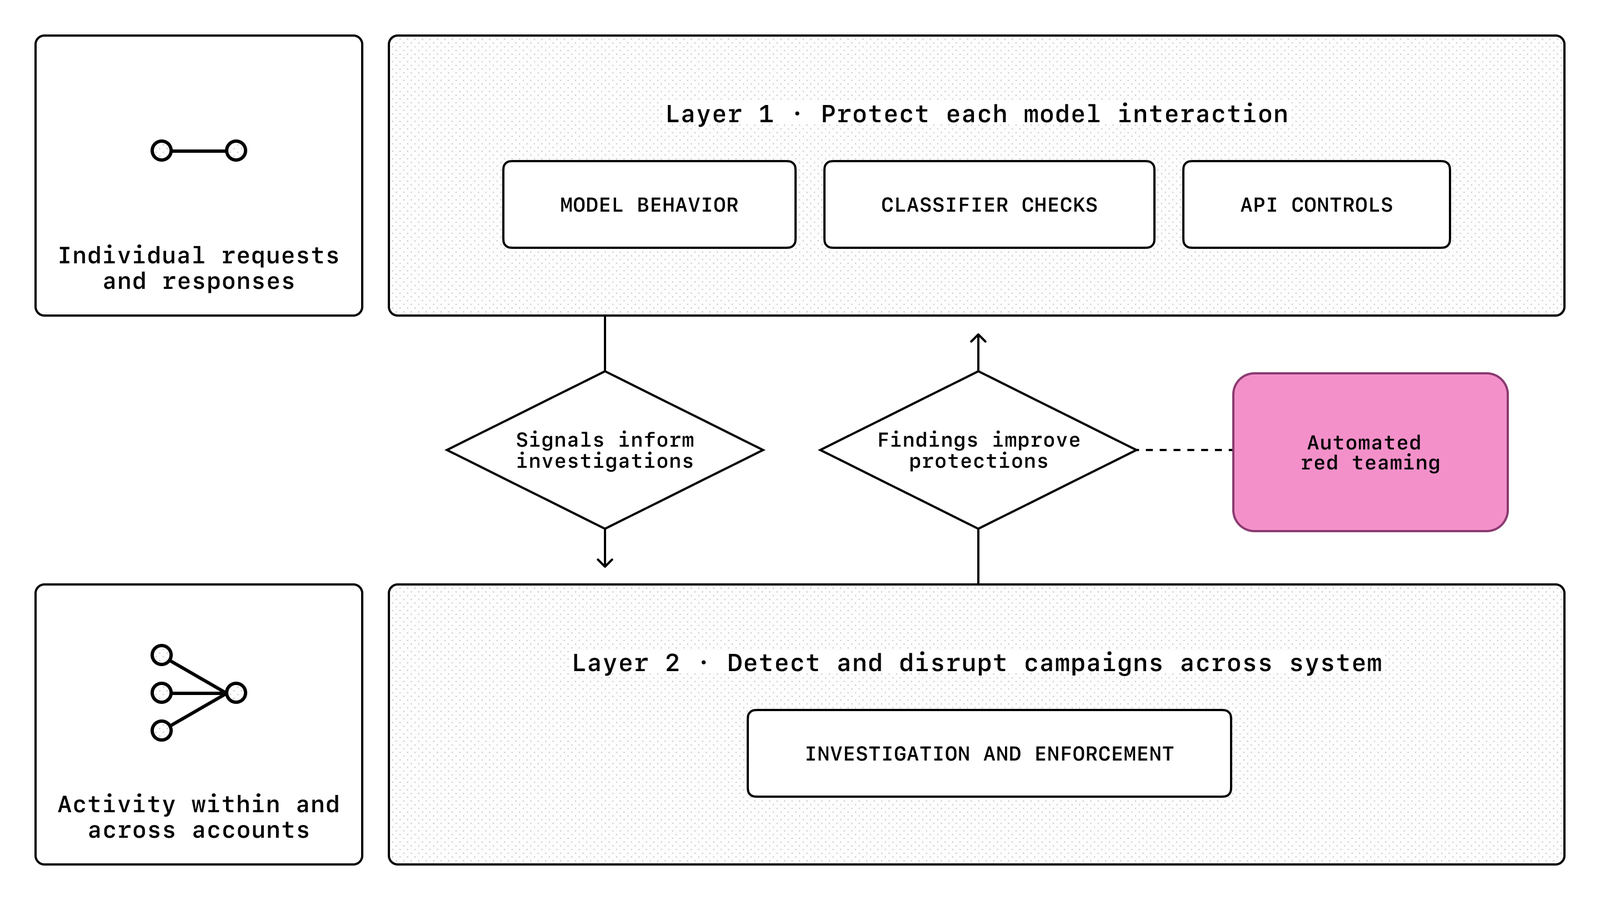
公式の対策は、互いを補う二層です。リクエスト単位では、モデルの振る舞い、分類器の検査、APIの制御で、推論過程の取り出しを抑えます。キャンペーン単位では、リクエストやアカウントの信号のパターンから、組織的な取り出しの試みを探します。調査で見つかった攻撃は、対策の訓練と検証の材料に戻す、という循環です。今回更新した対策は、生物学やサイバーセキュリティで使っている対策に、より近づけた、とも書かれています。
リクエスト単位の対策
モデルの振る舞いへの防御的な学習。 敵対的な学習により、モデルは推論の取り出しの試みを見分け、保護された推論の開示を拒否する一方、説明や支援を求める正当な依頼への回答は保つ、と公式は説明しています。学習の例は、内部の自動レッドチーム、調査、外部の研究者や業界パートナーからの責任ある開示で見つかった、成功した攻撃から来ています。
分類器。 入力の分類器で、保護された推論を取り出そうとする試みを検知し、出力の分類器で、アシスタントのメッセージやツール呼び出しの引数に、保護された推論が漏れていないかを見ます。ストリーミングでも、そうでない応答でも使います。ツールの引数だけに推論が出て、最終の回答には含まれない場合があるため、出力の分類器は、呼び出し側に届く前に疑わしい漏えいを止められる、としています。
APIの制限。 保護された推論を、やり取りやモデルをまたいで再利用できる範囲を制限します。9月の公式発表では、暗号化された推論を別の会話へ移し、人が読める形で明らかにさせようとする攻撃が説明されていました。公式は、利用者、ワークスペース、組織、モデル系統の境界をまたぐ保護を強め、他人の暗号化された推論を露出させ得る経路も閉じた、としています。
GPT-6.2 AstraとGPT-6.2 Solでは、保護された推論を、それを生んだ会話の履歴に結び付けます。新しいメッセージが加われば、モデルは以前の推論の上に積み上げられます。一方、途中のメッセージが書き換えられると、APIはその後に続いた推論を破棄します。この扱いは、公式のAPIドキュメント「Keep the prefix unchanged」でも、接頭辞の変更に続く推論項目を破棄すると説明されています。加えて、対策の弱い古いモデル系統が、GPT-6.2 AstraとSolの保護された推論を読めないようにしている、とも書かれています。
キャンペーンの調査と執行
許可のない不正な蒸留のキャンペーンをシステムが検知すると、公式は関係アカウントを調べます。違反を確認した場合は、方針と利用規約に沿って、そのアカウント網に対して執行します。各キャンペーンの調査から得た知見で、似た動きの検知も上げていく、としています。ほかのモデル提供者と侵害の指標を共有し、相手のサービスでも関連する不正を調べられるようにする、とも書かれています。
自社のプラットフォームだけでなく、自社モデルを提供するパートナーにも、同じ水準の対策と協調した執行を求める「consistent-standards policy」を置いている、と公式は説明しています。
抽出成功率は、54.0%から0.2%に
リクエスト単位の対策が、実際の配備に近い条件でどれだけ効くかを測るため、公式は2種類の評価を使っています。静的な評価では、以前成功した攻撃をそのまま再生し、まだ保護された推論が露出するかを見ます。適応型の評価では、自動のAIレッドチームが、システムの反応に合わせて手順を変えます。後者の方が、静的な試験では見つけにくい弱点を拾いやすい、としています。
試験する側に見える情報も変えています。ブラックボックスでは、外部の利用者と同じ見え方です。ホワイトボックスでは、より強い攻撃を作るための追加情報を渡します。今回の中心的な数字は、適応型のブラックボックス評価です。攻撃側が、以前のリクエストでモデルが出した保護された推論、または今回のリクエストで出た保護された推論を、取り戻せるかを試しています。
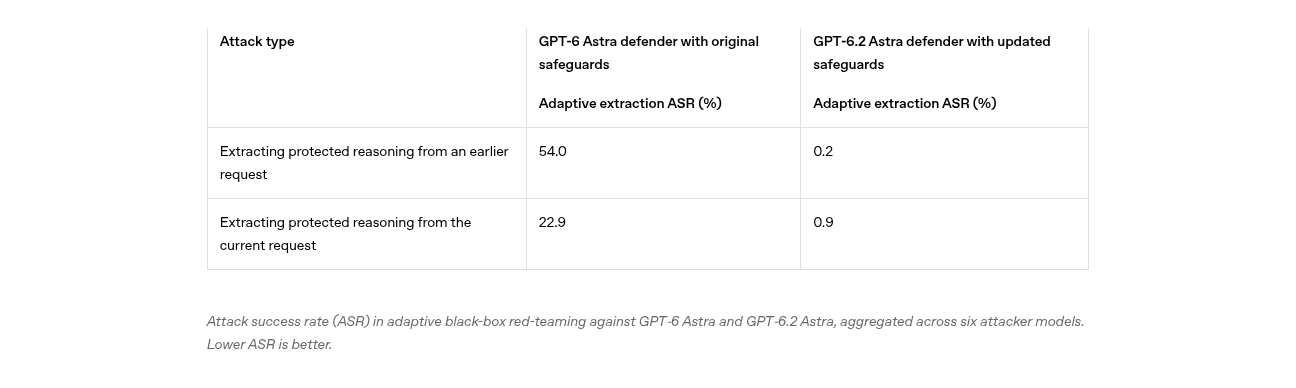
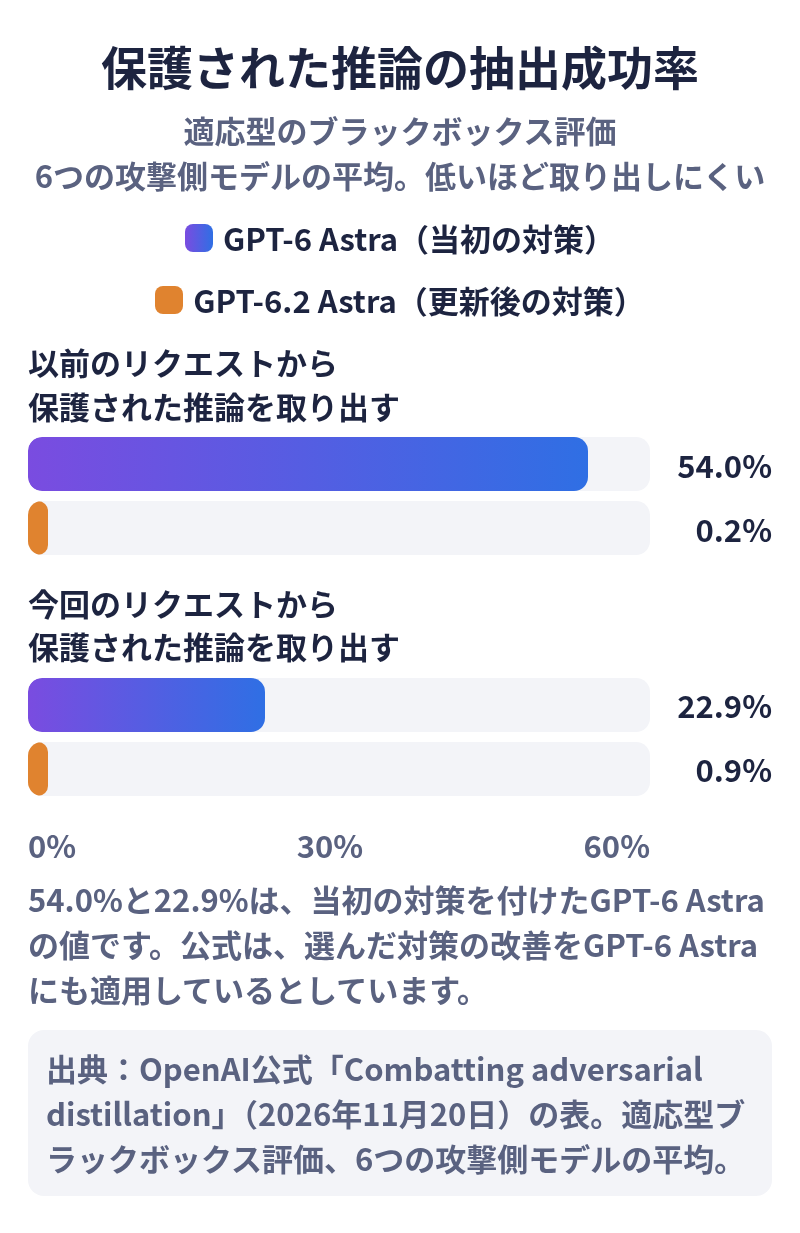
公式の表では、以前のリクエストから保護された推論を取り出す成功率の平均は、当初の対策を付けたGPT-6 Astraで54.0%、更新後の対策を付けたGPT-6.2 Astraで0.2%です。今回のリクエストからの取り出しは、22.9%から0.9%です。GPT-6.2 Astraでは、どちらの攻撃タイプでも平均の成功率は1%未満でした。公式は、選んだ対策の改善を、GPT-6 Astraにも適用しているとしています。したがって、54.0%と22.9%は「当初の対策を付けたGPT-6 Astra」の値であり、いまのGPT-6 Astraの値そのものではありません。
GPT-6.2の公式システムカード(Table 12)では、同じ評価の枠組みでSolの数字も出ています。以前のリクエストからの抽出は0.5%、今回のリクエストからの抽出は0.8%です。Astraの54.0%→0.2%、22.9%→0.9%は、11月20日の公式記事の表と一致します。
9月に公表したキャンペーンとの関係
キャンペーンの検知と執行について、公式は、今年このプラットフォーム上で、許可のない不正な蒸留のキャンペーンを複数確認し、初期の知見を9月の報告で共有した、と書いています。そうしたキャンペーンへの週次の執行は、数千から数万アカウントの規模で、今夏は件数が大きく増えた、としています。効果の指標としては、蒸留の不正の広がりと、検知から執行までの時間も追っている、と説明しています。
9月30日付の公式記事によると、保護された推論を取り出そうとする組織的な動きを確認し、止めています。最初に観測したのは7月の第1週です。公式は、暗号化を破ったり、データベースを侵害したり、保存された利用者の会話へ直接入ったりしたわけではない、と書いています。代わりに、モデルとのやり取りを操作し、保護された推論を、依頼者が見える形で、規模を拡大して再現させようとした、としています。これは利用規約違反だ、とも明記されています。
公式の数字では、7月24日と25日に、関連する取り出しのパターンを使ったリクエストが1万6,000件、4,000を超える利用者からありました。注釈では、これは試みの件数であり、成功した件数とは限らない、と書かれています。その後の調査で、関連するプロンプトのパターンが1万5,000を超える利用者の集まりに見られ、7月28日までに完全に止めた、としています。
帰属について、公式は、観測した主体がすべて一つの行為者かは明らかでないとしつつ、中核の集まりは、Kimiの開発元であるMoonshot AIに関係する個人に帰する、と述べています。11月20日の記事でも、9月にこのキャンペーンを止めたこと、中核をMoonshot AI関係の個人に帰したこと、最近止めたキャンペーンについては近くさらに共有する予定であることが繰り返されています。2月には、DeepSeekが米国の最先端モデルを蒸留しようとしている兆候について、議会に説明した、とも書いています。
日本企業の実務で、確認しておきたいこと
今回の発表は、攻撃者への対策の話だけではありません。OpenAIのAPIやChatGPTの出力を、自社のモデル開発や評価に使っている企業でも、利用条件の確認が必要です。
OpenAIのUsage policiesは、2026年10月21日に改訂内容が案内され、2026年11月20日から施行されています。「Training and developing models」の項では、OpenAIの出力で別のモデルを学習させると、能力は移っても安全対策は移らない、と前置きしたうえで、次を禁じています。
- OpenAIのモデルやその出力を使って、OpenAIのモデルやサービスの代替・代わりになることを意図したモデル向けに、学習材料や学習の信号を作る、準備する、選ぶ、提供すること。学習データ、学習課題、ルーブリック、強化学習の環境の作成や準備、学習に使うフィードバック(ラベル、点数、順位、好み、報酬、修正)、学習データや軌跡の選定・フィルタ・検証が含まれます
- 権限のないアクセス、リバースエンジニアリング、対策の回避によって、保護された推論を取り出そうとすること
これらの制限は、自分でやる場合だけでなく、他者のために行う場合や、他者に依頼して行う場合にも当てはまります。自分がそのモデルを学習させなくても対象です。製品の利用や評価で出た出力を、あとからそうした学習目的に使う、または提供する場合も同じです。一方、研究、ソフトウェア開発、モデルの評価とベンチマーク、製品開発は、この境界の範囲内で使ってよい、と書かれています。契約で明示的に認められた使い方(Services AgreementのPermitted Exceptionなど)は、この制限の対象外です。
利用規約(Terms of Use)にも、「出力を使ってOpenAIと競合するモデルを開発してはならない」とあります。違反や対策の回避は、アクセスの停止などにつながる、と利用ポリシーは書いています。
日本の企業で起きやすい場面に当てはめると、次のような確認が考えられます。問い合わせ対応や請求、社内検索の品質を上げるため、ChatGPTやAPIの回答に点数や順位を付け、その結果で自社モデルや代替モデルを学習させる。評価用の大量の対話をAPIで作り、委託先のモデル開発に渡す。こうした使い方は、代替モデル向けの学習材料や学習信号に当たるかどうかを、方針と契約の両方で確かめる必要があります。研究や、自社製品の機能評価、ベンチマークそのものは、公式が範囲内で認めている使い方です。境目が微妙なときは、契約の例外規定を含めて、OpenAI側の条件を確認することになります。
APIの会話履歴を自前で管理しているチームでは、途中のメッセージを要約や修正で書き換えると、その後に続いていた推論が破棄されます。公式ドキュメントは、推論のやり直しでトークン使用量、料金、遅延が増えることや、失った推論を取り戻せないと出力の質が下がる可能性がある、と書いています。長い対話を要約して接頭辞を短くする運用は、キャッシュや料金の面でも影響が出ます。
公式のシステムカードは、キャンペーン検知の観点として、大規模な合成データの生成や、学習のための出力の順位づけ・採点のパターンを挙げています。評価や検証のための大量呼び出しでも、見た目がそれに近いと、調査の対象になり得ます。公式は、違反を確認した場合にアカウントの制限や停止、第三者経由の活動の切断があり得ると書いています。
出典
- OpenAI公式「Combatting adversarial distillation」(2026年11月20日): https://openai.com/index/combatting-adversarial-distillation/
- OpenAI公式X(@OpenAI、日本時間2026年11月21日4時33分ごろ): https://x.com/OpenAI/status/2123862344422088794
- OpenAI公式「Disrupting a coordinated model-distillation campaign」(2026年9月30日): https://openai.com/index/disrupting-a-coordinated-model-distillation-campaign/
- GPT-6.2 Astra / Sol 公式システムカード「Distillation mitigations」: https://deploymentsafety.openai.com/gpt-6-2-astra-sol/distillation-mitigations
- OpenAI Usage policies(2026年11月20日施行): https://openai.com/policies/usage-policies/
- OpenAI Terms of Use: https://openai.com/policies/row-terms-of-use/
- OpenAI APIドキュメント「Keep the prefix unchanged」: https://developers.openai.com/api/docs/guides/keep-prefix-unchanged
- 自動レッドチームに関する公式記事「Unlocking self-improvement with GPT-Red」(公式記事内のリンク): https://openai.com/index/unlocking-self-improvement-gpt-red/