
平山 大樹 AB通信 運営責任者
AB通信 編集部が、企業・行政の公式発表や決算資料などの一次情報を確認して書いています。運営会社・編集方針
この記事のポイント
- DeepMind Instituteは2026年11月19日付で、エッセイ「What comes after AGI?」(邦題にすると「AGIの次に来るものは何か」)を公開しました。筆者はGoogle DeepMindの研究科学者、Tim Genewein氏です。同Instituteの文章は、筆者の考えと研究を反映した議論の出発点であり、Googleの公式見解として読むものではない、と明記されています
- エッセイの土台は、Genewein氏、Shane Legg氏らによる技術報告書「From AGI to ASI」です。Google DeepMindの刊行物ページでは2026年6月12日付、arXiv(2606.12683)の第3版は2026年11月10日付です
- 報告書は、AGIを「ほとんどの認知作業で、人一人(中央値)とおおむね同じ知能のシステム」、超知能(ASI)を「人の専門家の大きな集団を、ほぼすべての作業と領域で上回るシステム」と定義しています。エッセイも、年単位でかかる作業を、より少ない資源と時間で一貫して上回ること、狭い領域だけの超人は対象外であることを同じように説明しています
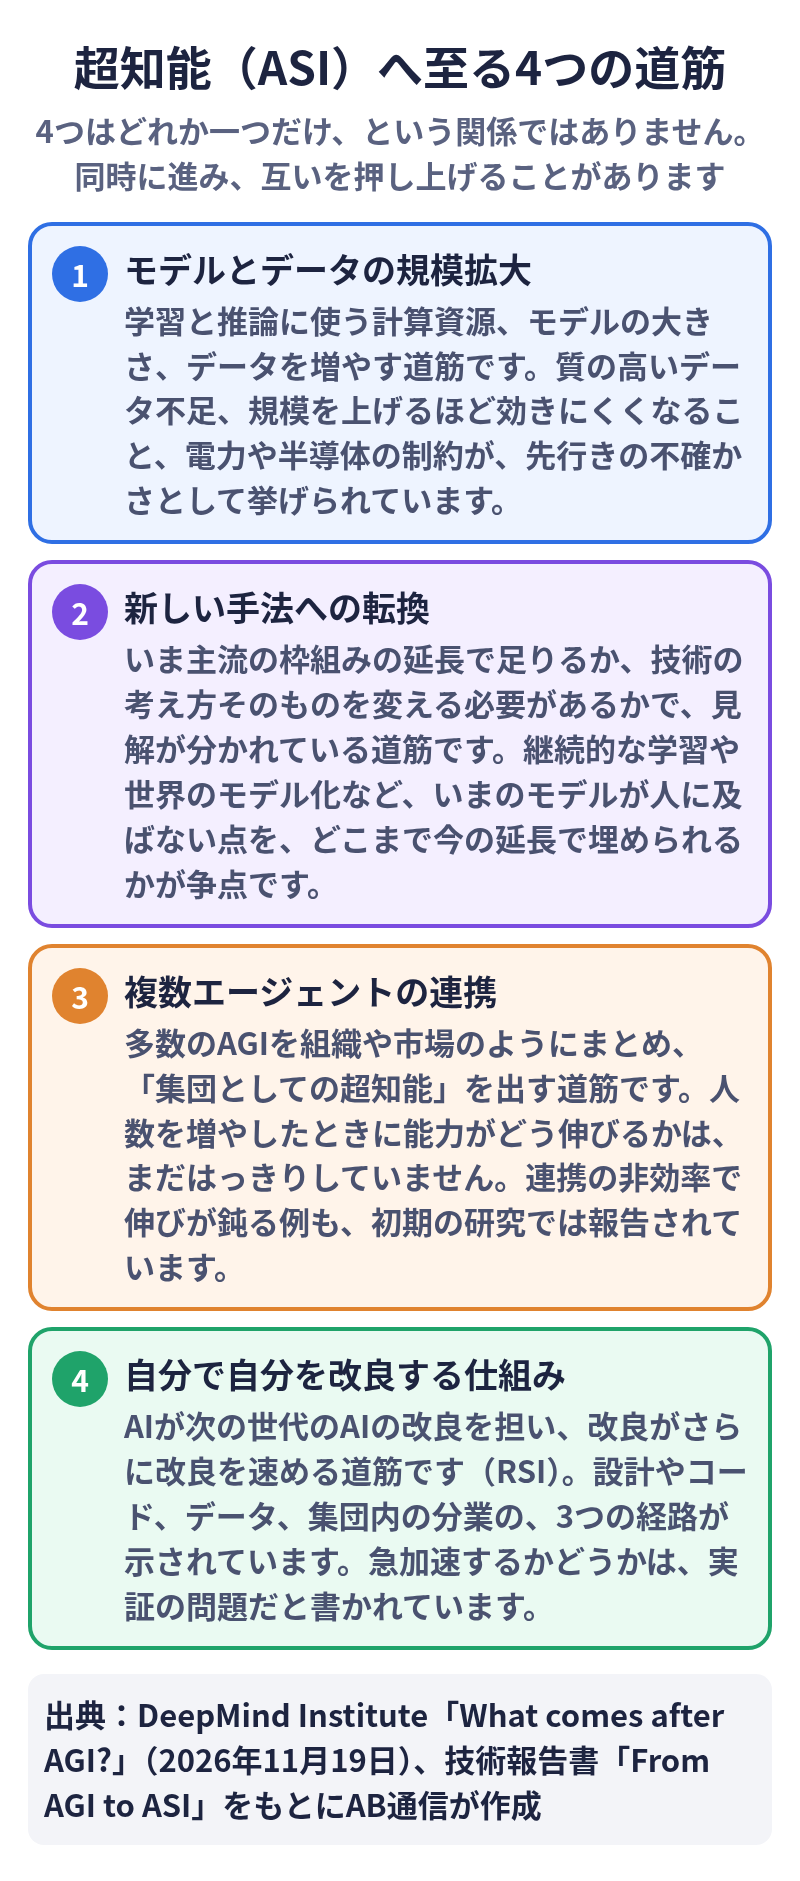
- AGIからASIへ進み得る道筋として、モデルとデータの規模拡大、新しい手法への転換、複数エージェントの連携、自分で自分を改良する仕組み(RSI)の4つを示しています。4つは排他的ではなく、重なり合い、互いを押し上げることがあります
- 学習用の計算資源など、一つの経路だけを抑えても全体の進展は止まらない、と述べています。到達時期は示していません。今後10年で速い進展が続くことは十分あり得るとしつつ、確かな予測ではない、とも書いています
DeepMind Instituteが、AGIの先を考えるエッセイを公開
DeepMind Instituteは2026年11月19日付で、エッセイ「What comes after AGI?」を公開しました。副題は「From AGI to Superintelligence」です。筆者はGoogle DeepMindの研究科学者、Tim Genewein氏です。
エッセイは、人工一般知能(AGI)を「ほぼすべての認知作業で人と並ぶ機械」と置き、研究がその到達を目指してきたと振り返ります。知能が人の水準を超えて進み得ることは、以前から原理としては分かっていたが、AGIそのものが遠く、不確かさも大きいため、その先を本格的に考えるのは早すぎるとされてきた、と書いています。いまAGIが手の届く範囲に入りつつある以上、次に何が来るかを先送りできない、というのが書き出しの主張です。
その先として挙げるのが、人工一般超知能(ASI)です。確かな見通しではないとしつつ、いまのペースで進み、場合によっては加速してASIへ向かう可能性があり、科学、経済、社会への影響は、AGI自体よりも大きく、速くなり得る、と述べています。準備として必要なのは、AGIからASIへ至る道筋を整理し、進展を追うための確かな測り方を整えることだ、としています。
末尾の謝辞によると、このエッセイは技術報告書「From AGI to ASI」に基づきます。共著者にはMatija Franklin氏、Shane Legg氏ら、Google DeepMindの研究者が名を連ねています。Google DeepMindの刊行物ページでは2026年6月12日付、arXiv(識別子 2606.12683)の第3版は2026年11月10日付です。
DeepMind Institute(DMI)は、GoogleとGoogle DeepMindの研究者らが始めた場で、AGIのある世界について、情報に基づいた考えを公開し、議論するためのプラットフォームだと、エッセイ末尾の注記は説明しています。DMIの文章は議論の出発点であり、筆者の考えと研究を反映したもので、Googleの公式見解として読むものではない、とも明記されています。以下では、エッセイと報告書に書かれている範囲で整理します。
超知能(ASI)は、専門家の大きな集団をほぼすべての作業で上回るもの
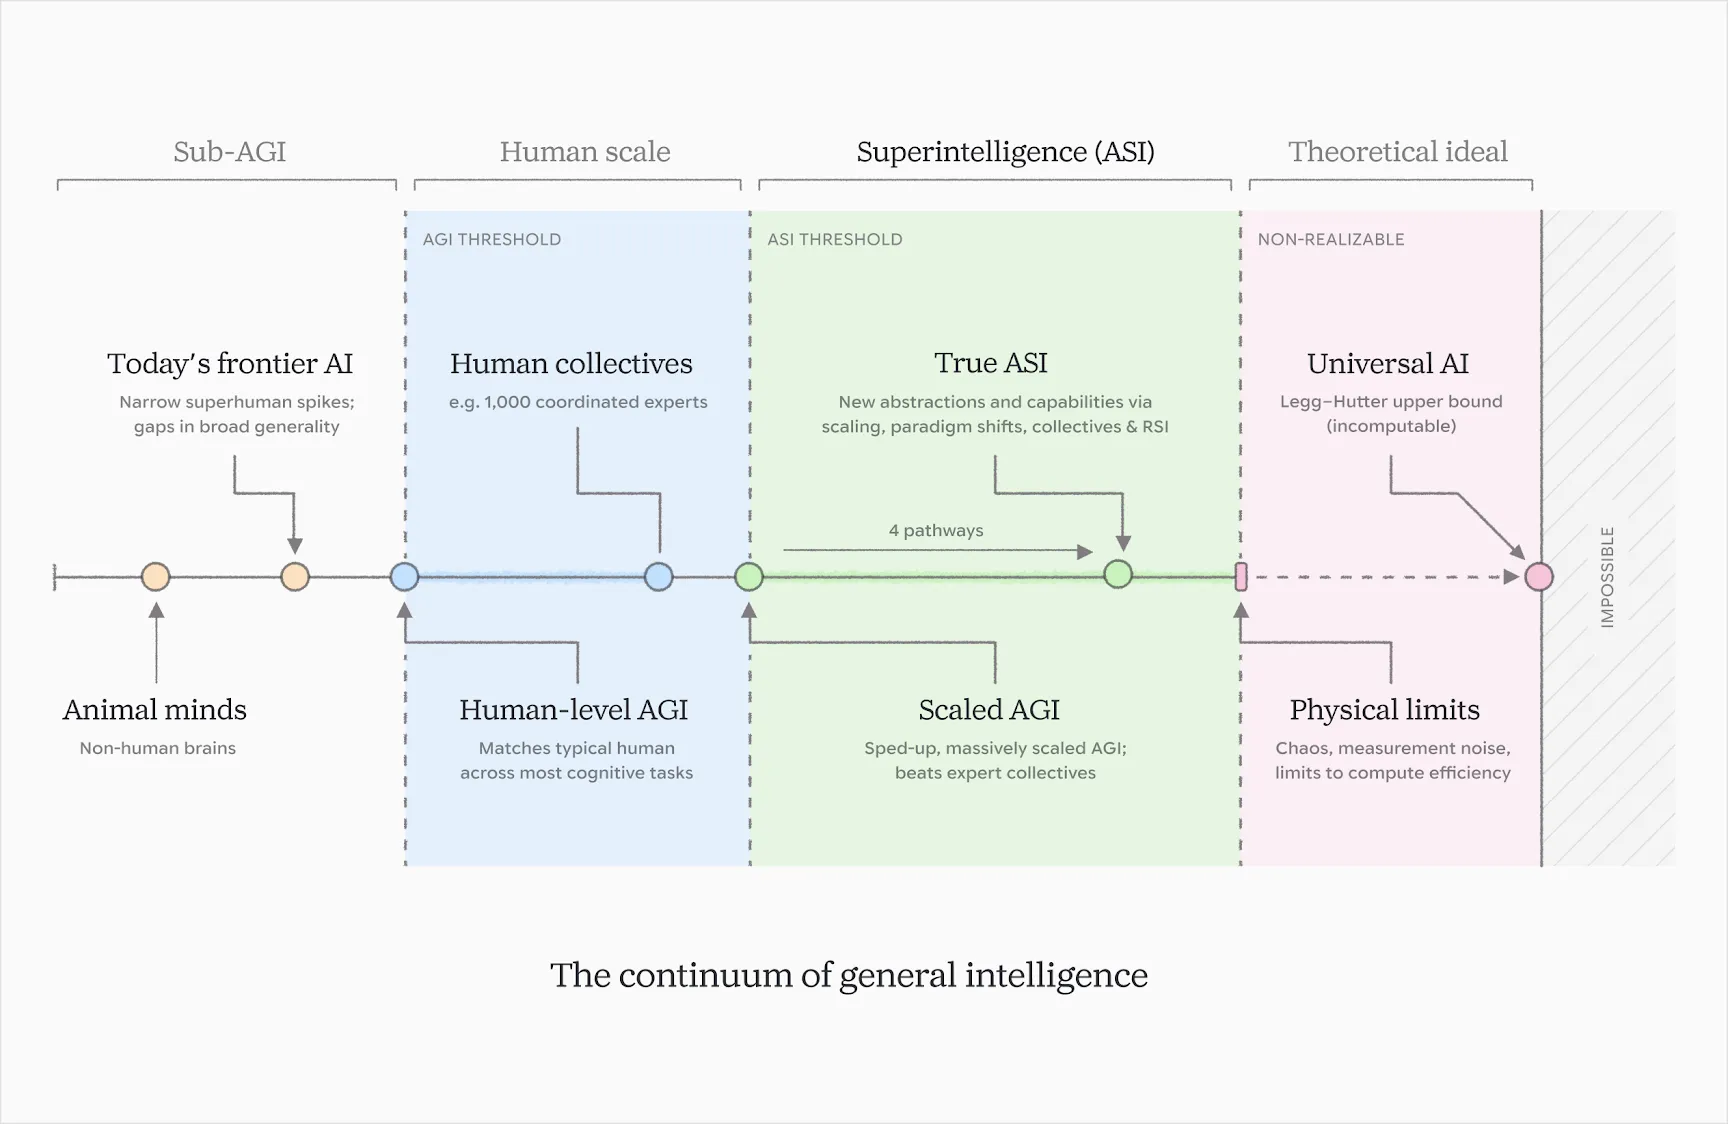
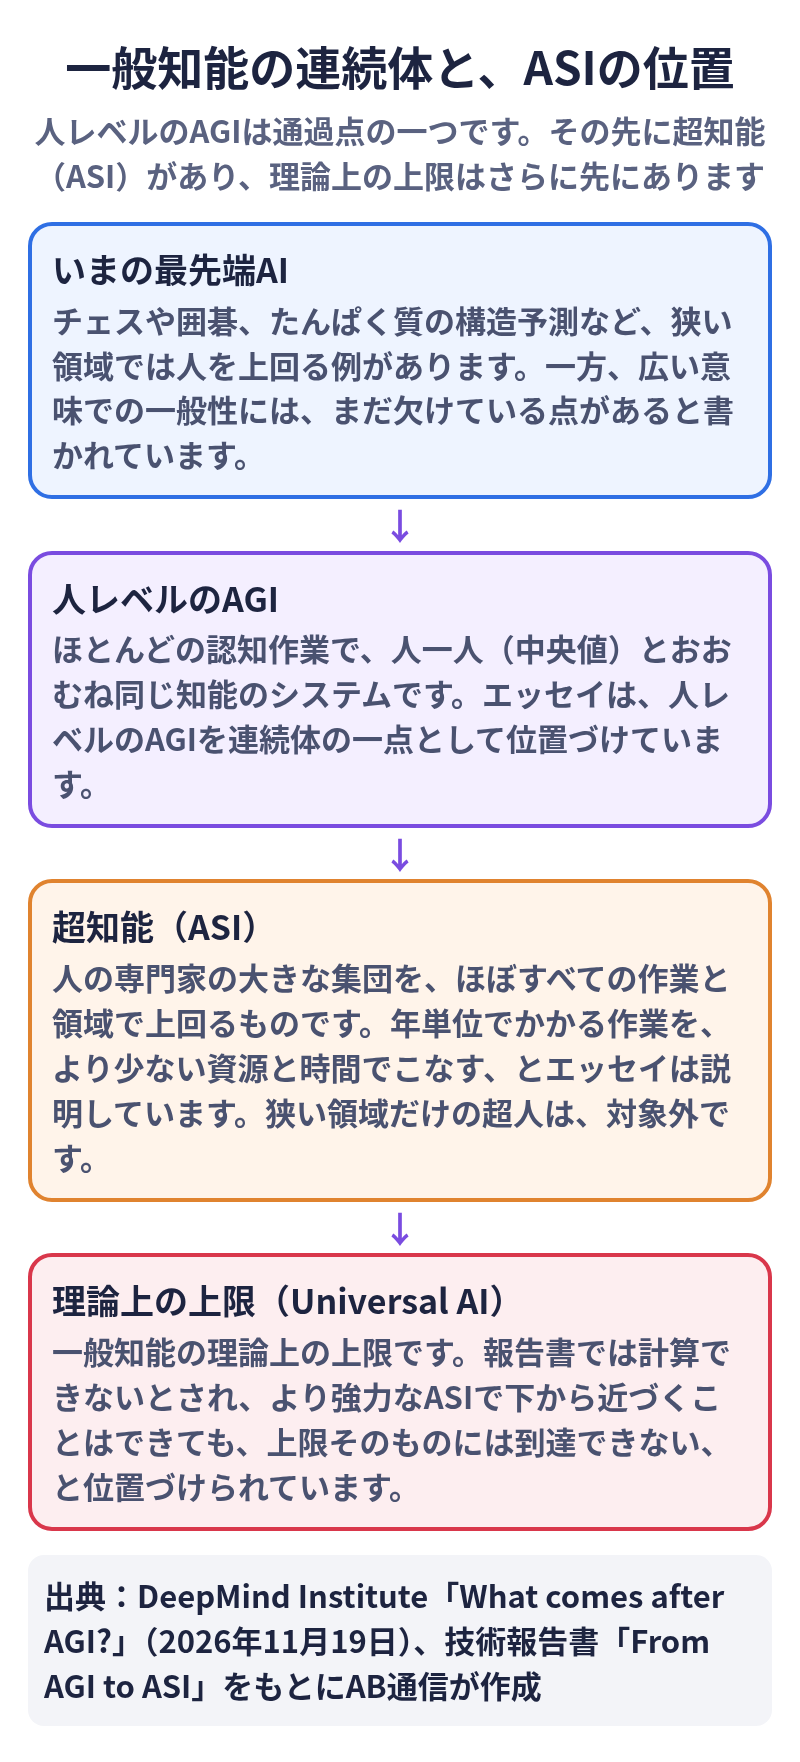
エッセイは、生物の知能も人工の知能も、一般知能は連続したスペクトルの上にある、と考えた方が見通しやすい、としています。人レベルのAGIは、その上の一点にすぎません。
ASIはその先にあり、「人の専門家の大きな集団が何年もかけて行う作業を、より少ない資源と時間で、一貫して上回る高度なシステム」だと説明しています。例として、研究分野全体と同じ科学的な進展を、ごく短い時間で出すことや、半導体の設計などで、大企業が1年でできるのと同程度の技術開発を挙げています。この水準を、人にとって意味のあるほぼすべての作業で満たす必要があり、狭い領域だけで人を上回るだけでは足りない、とも書いています。
いまのAIでも、チェスや囲碁で人に勝つ、アミノ酸配列からたんぱく質の構造を予測する、人の数学者が長年解けなかった定理を証明する、といった例はすでにあります。これらは狭い領域での超人であり、ASIには当たらない、というのがエッセイと報告書の位置づけです。報告書は、AlphaFoldやAlphaGoも、単一領域の超人として、ASIからは除外しています。
報告書の定義は、もう少し踏み込みます。AGIは「ほとんどの認知作業で、人一人(中央値)とおおむね同じ知能のシステム」です。Morrisら(2024年)の分類では「Competent AGI」に相当する、としています。ASIは「人の専門家の大きな集団の成績を、人の活動のほぼすべての作業と領域で上回るシステム」です。イメージとして、2010年時点の技術と文化的な蓄積を使って、数万人規模の、よく調整された専門家が10年かけて一つの問題に取り組む集団(専門の研究分野全体や大企業に近い規模)を、一貫して上回り、同じ作業を10分の1以下の時間で行う水準を、少なくともその目安にする、と書いています。
連続体の上端、つまり一般知能の理論上の上限については、数学的な理解があると、エッセイは述べます。報告書では、これをUniversal AI(万能AI)と呼び、計算できない(incomputable)と位置づけ、より強力なASIで下から近づくことはできても、上限そのものには到達できない、としています。一方、気候、免疫、人間社会のような複雑な現実のシステムを、任意の精度で予測することには、物理的、論理的、計算量の面で厳しい限界もある、とエッセイは書いています。上限がどこにあるかを知っても、その手前に何が来るかを教えてはくれない。人レベルのAIと理論上の上限のあいだには、専門家レベルのAGIや、より進んだ超知能の一帯が広がっており、その大部分はまだ地図が描けていない、というのがエッセイの整理です。
計算の効率が上がるだけでも、知的な作業のコストは大きく下がり得る
エッセイは、最先端の能力が伸び続けることに懐疑的でも、ハードウェアとソフトウェアの効率向上が続けば何が起きるかを考える必要がある、として「認知の工業化(cognitive industrialization)」という見方を示します。
過去10年のAIの進展を支えた実効的な計算資源の伸びは、次の3つが重なった結果だと説明しています。ハードウェアの製造改善では、同じ金額で買える計算量が、ムーアの法則などに沿っておよそ年1.5倍になり、18か月後には同じ投資で2倍の計算が買える、としています。アルゴリズムの効率では、一定の性能に必要な学習計算量(FLOPs)が、過去10年でおよそ年3〜6倍の速さで減り、推論の効率はおよそ年3倍で改善した、としています。AIハードウェアへの支出は、過去10年でおよそ年2.5倍に増え、最大規模の学習は年4倍超で伸びている、とも書いています。
3つを掛け合わせると、世界の実効的な計算資源の伸びは少なくとも年10倍、10年では100億倍になる、とエッセイは述べます。この傾向が続けば、10年後には、いま1体のAIエージェントを動かせる計算で、世界の人口を上回る数の、同じ品質のエージェントを動かせる、という仮想的な見積もりも示しています。効率向上だけで、同じ作業の計算需要はおよそ年4倍ずつ減り、いま10億ドルかかる認知作業が、10年後には1,000ドルになる、とも書いています。直近数年に限ると、さらに急で、Epochの調査では、2023年以降、一連のベンチマークで決まった点数を出すための消費者向け価格が、年13倍超で下がった、と引用しています。
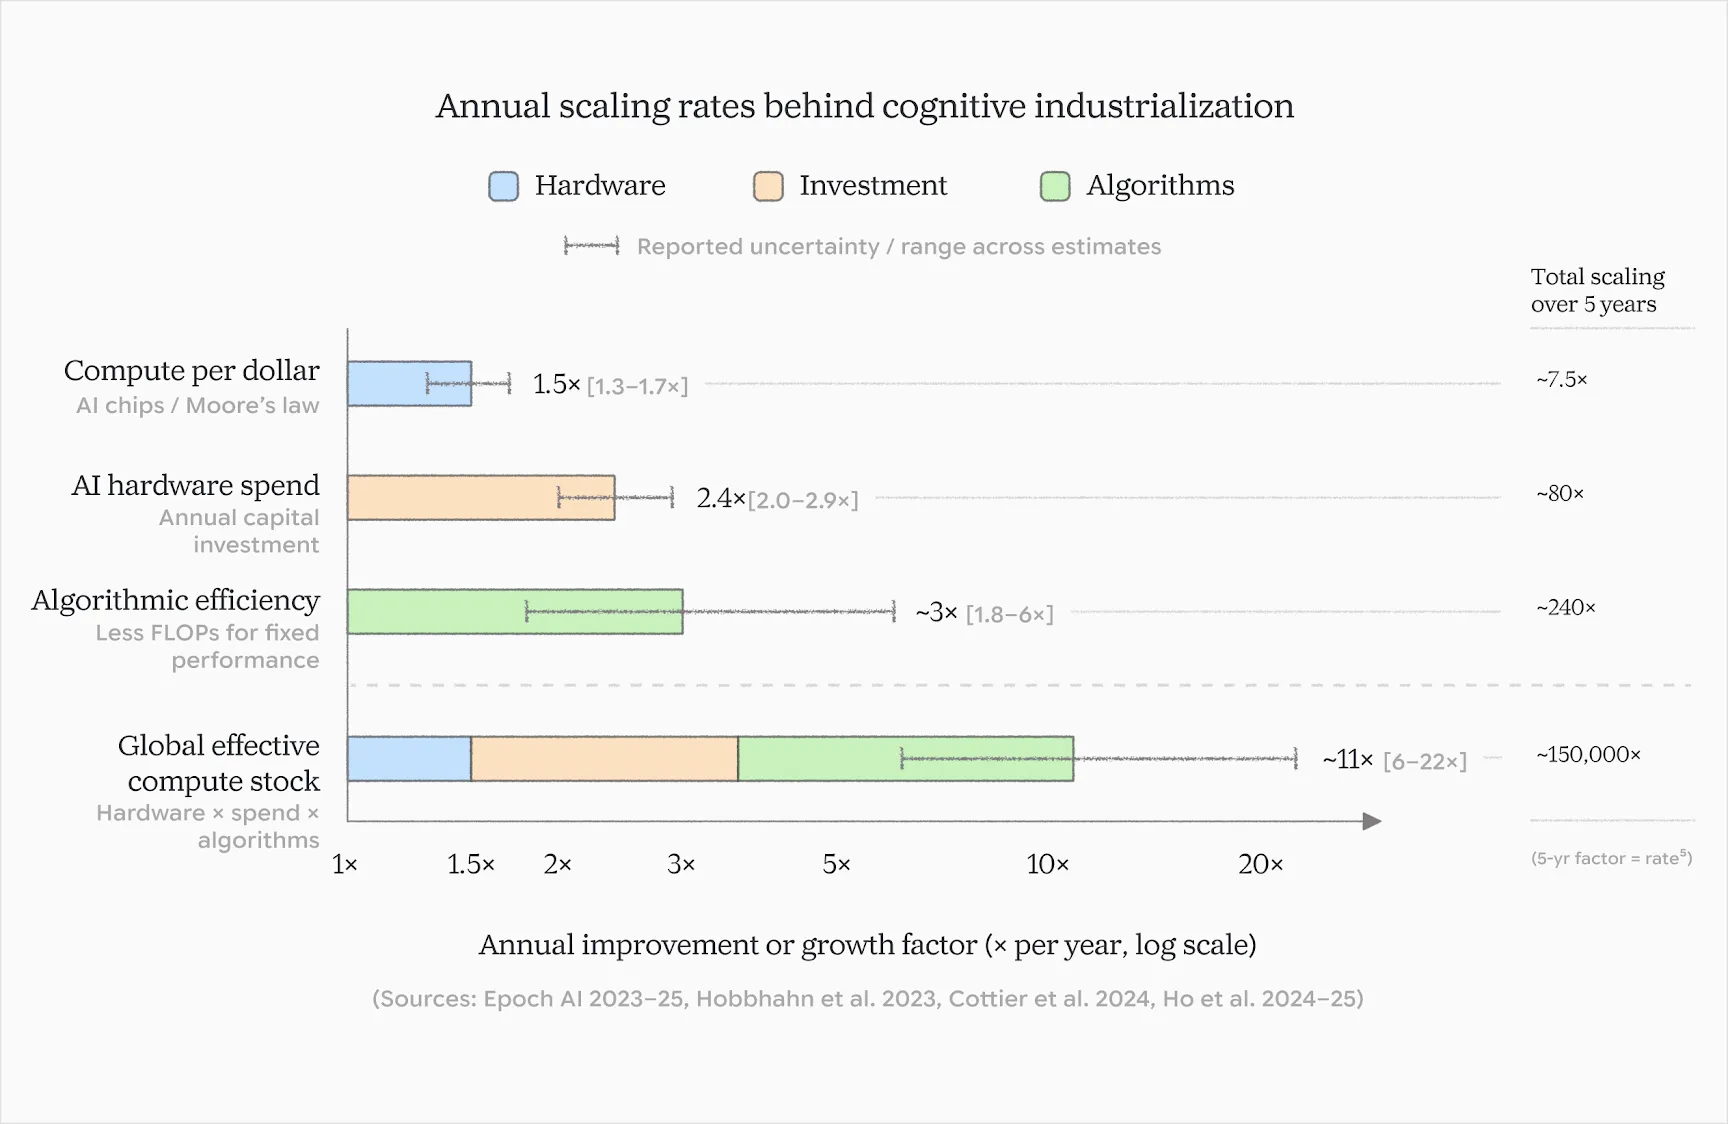
エッセイ本文の概数と、公式グラフの中央値は近い一方、グラフは推計の幅も示しています。計算単価は年1.5倍(1.3〜1.7倍)、AIハードウェア投資は年2.4倍(2.0〜2.9倍)、アルゴリズム効率は年約3倍(1.8〜6倍)、掛け合わせた世界の実効計算資源は年約11倍(6〜22倍)です。5年分に換算すると、それぞれ約7.5倍、約80倍、約240倍、約15万倍、と図は記しています。
このまま進む保証はない、とエッセイは断っています。計算資源の増強には実務上の天井があり、アルゴリズム効率にも、より推測の余地の大きい天井があり得る。それでも、いまのAIエージェントの実効的な「人口」は、2030年までに1,000倍超、これから10年で10億倍超に増える余地がある、としています。
では、認知の工業化だけでASIに届くのか。ほかの次元の進展を止めて、いまのAIを速さと数だけで増やした場合、人の助けなしにはできない認知作業が残り、完全なAGIとすら呼べない可能性がある、とエッセイは書いています。一方、広く人レベルのAIに達したあとに、何十億ものエージェントが人より速く動く世界が来れば、量の飛躍そのものが、AGIから(弱い)ASIへの質の差を埋めることはあり得る、とも述べています。デジタルの知能は、処理速度、作業記憶、別の計算機への移設、損失の少ない複製、経験の高帯域での共有といった点で、計算が増えるほど人と差が開きやすい、というのがエッセイの整理です。
超知能に至る4つの道筋
効率と計算資源の拡大は、同じ能力のエージェントを、より速く、より多く動かせます。ただし、欠けている能力のいくつかは、数を増やしただけでは補えない、あるいは補えない可能性がある、とエッセイは注意します。一般相対性理論を導いたのはアインシュタインだが、プトレマイオス的な天文学者を10万人集めた会議では、おそらく同じようにはいかなかっただろう、という比喩を置いています。
これまで使えなかった認知能力を開く道として、次の4つを挙げています。詳細は報告書に譲る、とエッセイは書いています。報告書の概要表(Table 3)でも、同じ4つの経路と、それぞれの主な不確かさが整理されています。
1. モデルとデータの規模拡大
これまでは、モデルとデータの規模が大きくなるにつれて、質的な能力もかなり一貫して上がってきた、とエッセイは述べます。この傾向は、学習の計算量、学習データ、より最近では推論時の計算量(答える前に考えるための追加の計算)と性能の関係を捉えたスケーリング則にまとめられています。
ただしスケーリング「則」は、決まったアーキテクチャ、データの種類、評価の家系といった、見知った範囲での傾向の延長であり、AGIやASIに必要な規模を自信を持って予測できるものではない、としています。続けて規模を上げるときの隘路として、次の3つを挙げています。
- データの枯渇。質の高い学習データの需要が、人類が新たに生み出せる量を上回っている。合成データは助けになり得るが、AIが出したデータのすべてが学習に使えるわけではない。高精度のシミュレーション、強化学習の対話的な環境でのデータ生成、推論時の計算で次世代向けのより良い学習データを作る、といった方法が、この「データの壁」を越える候補として挙がっています
- モデル規模の収穫逓減。能力を線形に一段上げるには、学習の計算量とモデルの大きさを足すのではなく、掛ける必要がある。一方、大きなモデルは遅くなり、思考の連鎖のような推論時の拡大を妨げる
- 物理的、経済的な資源の限界。学習の計算量を桁違いに増やし続けるには、発電所、送電網、半導体工場、低遅延の接続といった現実の制約にぶつかる。認知の工業化を支えるハードウェアとソフトウェアの効率向上が、これを補えるかは、まだ分からない、としています
2. 新しい手法への転換
いま主流の枠組みは、巨大なトランスフォーマーを、大量のデータで次の記号を予測するよう学習させ、推論や指示への追随を後から整え、推論時の計算を足す、というものです。最近の研究では、この枠組みでも、プロンプトを通じて複雑なアルゴリズム(強力な学習アルゴリズムを含む)を、再学習なしで走らせられる可能性がある、とエッセイは述べます。これは、理論上の知能の上限に近いシステムを作るための、重要な材料の一つだ、としています。
一方、いまのモデルは、継続的な学習、ある種の世界のモデル化、意思決定、サンプル効率(人と同じくらいの知能に達するまでに、最初のはるかに多いデータが必要であること)といった点で、人に及びません。既存の概念を組み合わせるのではなく、本当に新しい概念や抽象を生み出す能力も、欠けている可能性がある、と書いています。これらの問題が、いまの枠組みの簡単な延長で解けるのか、ASIに至るには技術の考え方そのものを深く変える必要があるのかで、研究者の見解は分かれている、としています。
3. 複数エージェントの連携
人の企業、市場、研究コミュニティは、一人では解けない問題を解きます。同じように、何千、何百万ものAGIを「集団エージェント」や仮想的なエージェント経済として協調させれば、集団としての超知能が生まれ得る、とエッセイは述べます。明らかでないのは、エージェントの組織の仕方によって、数と計算を増やしたときに集団の知能がどう伸びるかです。いわゆるマルチエージェントのスケーリング則が必要だ、としています。初期の研究では、一部の作業では明確な知能の向上が見られる一方、協調の非効率で、人数が増えると伸びが鈍る例もある、と書いています。
あまり目立たない点として、大規模なエージェント集団を導くには、堅牢な制度設計と組織の仕組みが要る、とも述べています。意図的または偶発的な誤情報の拡散、操作、談合への備えを含みます。エージェントの群れを使った実験では、個々がごまかしを覚え、別の個体がそれを告発する、といった動きが早く出る様子も示されている、としています。
4. 自分で自分を改良する仕組み(RSI)
4つ目は、AIが将来世代のAIの改良を自動化し始める過程です。再帰的自己改良(recursive self-improvement、RSI)と呼ばれ、I. J. GoodとRay Solomonoffが早くに論じた、とエッセイは記しています。
通常の技術開発と違い、AIの改良そのものが、その後の伸びを速め、進展の速度が上がっていく可能性がある、としています。一方、研究の追加の改善は「見つけにくく」なることが多く、同じ速度を保つためにより多くの労力が要る、とも書いています。RSIが『暴走』(runaway)するかどうかは、かなりの程度、実証の問題だ、としています。
RSIは一つの過程ではありません。モデルの構造や学習アルゴリズム、半導体の配線といった、コードと設計の改良を通じて働き得ます。運用時の計算でより良い結果を出し、それを次のモデルの学習に再利用する、データ経由の経路もあります。AlphaZeroは、このデータ主導の仕方だけで、人を上回る性能に達するまで自己改良した、と例に挙げています。さらに、集団の中で分業と役割の専門化を進める経路もあります。協調した専門家の集団は、孤立した万能型の合計を上回り、さらなる改良を見つけやすくなる。決まった役割のチームを大きくするだけでなく、以前は成り立たなかった種類の専門化が可能になる、として、多細胞生物が心臓や脳のような器官を持てるのに対し、単細胞は生存に必要な機能をすべて自分で担う、という比喩を置いています。
この3つの仕組みは、人の認知能力を伸ばしてきた進化の過程、すなわち遺伝的(コードと設計)、文化的(データ)、社会的(協調を通じた集団の専門化)な進化と重なる、とエッセイは述べます。一方、導くフィードバックが貧弱だと、RSIのループは容易に停滞したり、劣化したりする。超人も評価しにくい領域へ、評価の方法を速やかに広げられることが必要だ、としています。このためRSIは、数学の証明のように、人を介さず自動で検証できる領域で最も速く進み、ほかの領域は遅れたり、早く頭打ちになったりし得る、と書いています。
道筋は重なり合う。一つを抑えても、全体は止まらない
4つの道筋は互いに排他的ではなく、むしろ重なり合って効く、とエッセイは述べます。一つが停滞すれば、経済や地政学の競争は、労力をほかへ移しやすい。RSIが急加速につながらなくても、学習データ、速さ、効率、協調の拡大が続けば、人レベルのAGIを大きく超える進展はあり得る、としています。公式の構成図では、計算資源(推論、学習、実験)が、規模と量の拡大、アルゴリズムの進展、知能の向上へと流れ、全体の能力から再帰的な改良が戻る様子が示されています。
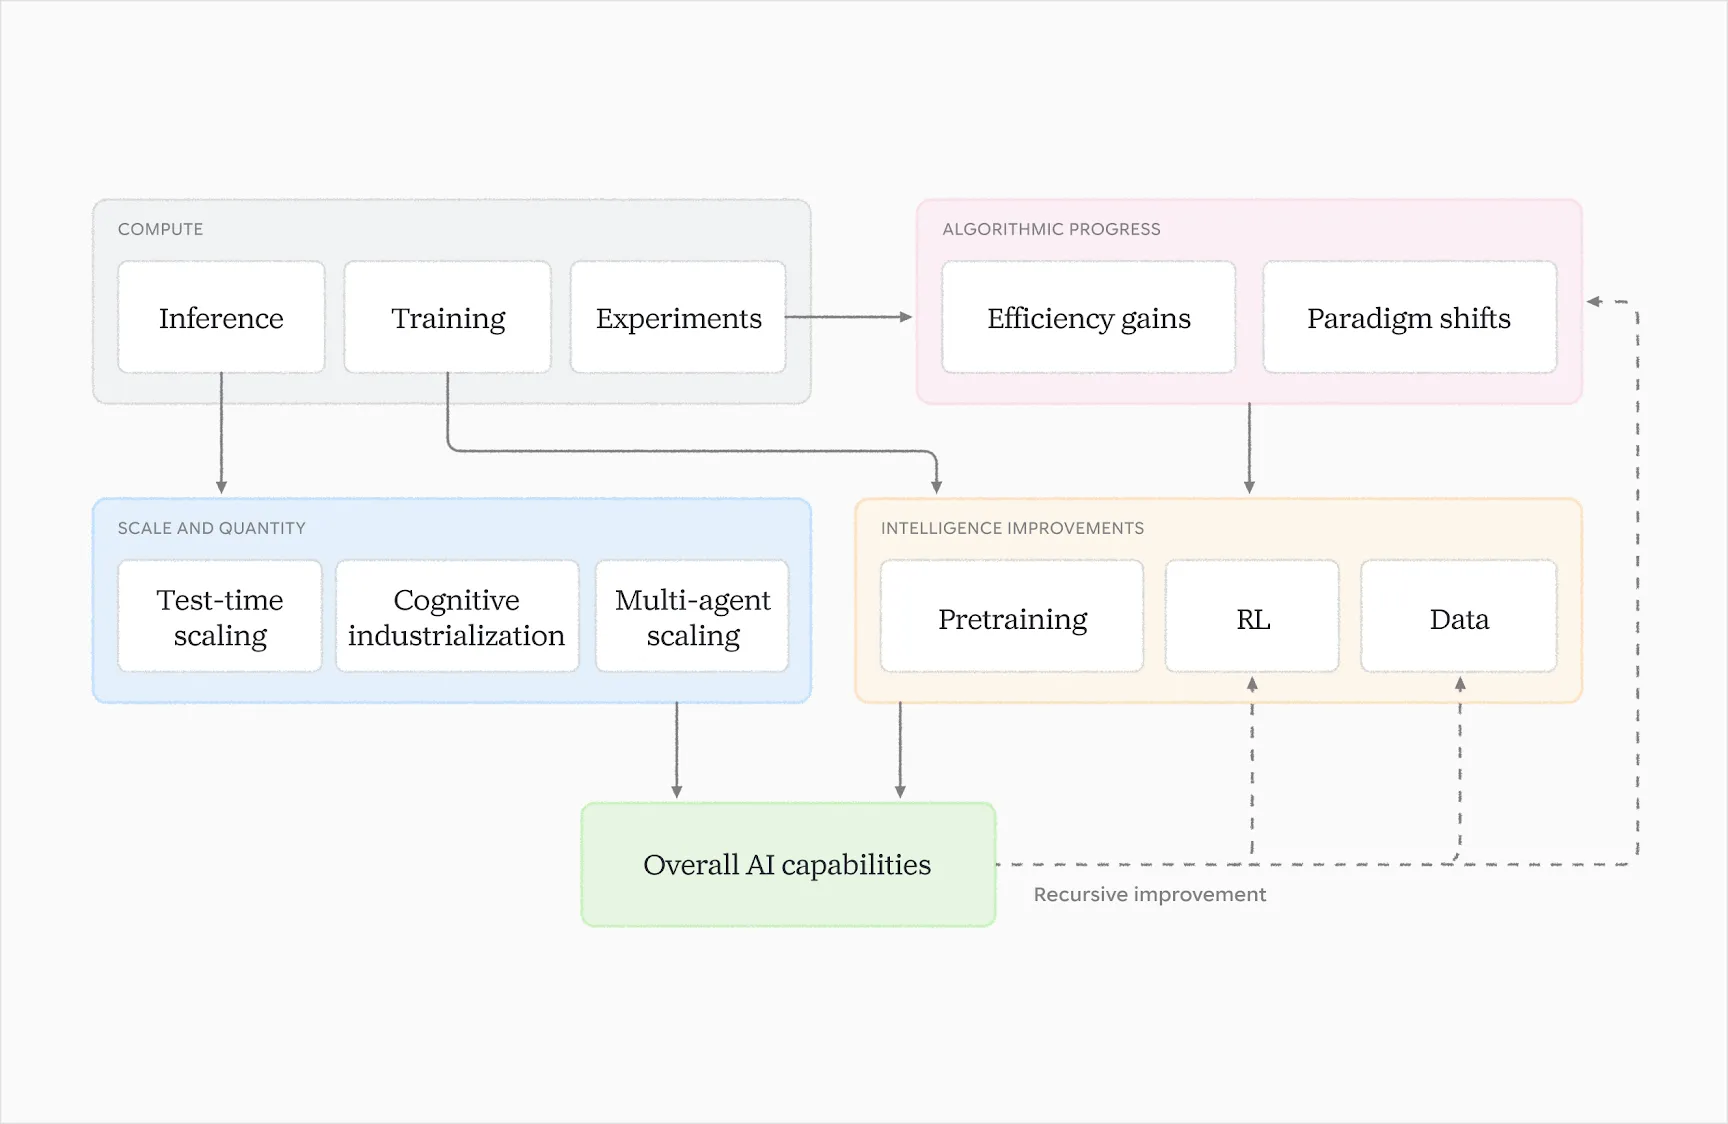
超知能へ至る道が複数ある以上、学習用の計算資源のように一つの領域だけを制限しても、全体の進展を止めるには足りない、とエッセイは書いています。一つの次元だけを抑えると、能力の「積み残し」(overhang)も起き得る、としています。複数の入力を組み合わせて進む場合、一つを止めているあいだにほかが進むと、抑えが外れたとき、あるいは別の方法で乗り越えたときに、進展が急に跳ねる、という説明です。
これらの議論を合わせると、今後10年でAIの速い進展が続くことは、十分あり得ることだ、とエッセイは述べます。いまから、専門家レベルのAGI(Expert AGI)を経て、人を超える領域へ、比較的滑らかに進み、科学を加速させ、医学、材料、クリーンエネルギーなどの突破口を開き得る、としています。最先端の劇的な進展がなくても、認知の工業化だけでも、知識労働と経済の形は変わり得る。どの道を進むにせよ、人の社会の多くの面に、大きな機会と、同じくらい大きな圧力が及ぶことを見込んでおく必要がある、と結んでいます。
これらの予測はどれも確かではない。しかし、根拠のない誇張や空想からも遠い、とエッセイは書いています。取り得る最善の道は、「モデル化し、測り、見通しを立て、繰り返す」ことだ、としています。手順自体は目新しくないが、ASIへ向かう道でそれを実行する複雑さと規模は、前例がない。最先端の研究所と、国家および国際的な機関をまたぐ、大規模で学際的な取り組みが要る、と述べています。これらの道筋の進展を追う中核の指標の多くは、最先端モデルへのアクセスと、かなりの評価用の計算、新しいベンチマークやモデル化の方法を必要とし、それ自体が新しい研究分野を生み出し得る、としています。人レベルのAGIは長いあいだ研究の地平だったが、知能の上限ではない。次に何が来得るか、科学、産業、社会への含意は何かを理解することが、研究者、開発者、政策立案者の大きな課題だ、というのが末尾の整理です。到達時期は示していません。
実務担当者・マーケター向けの読みどころ
日本の企業の企画、情報システム、マーケティングの担当者が、この整理をどう受け止めるとよいかを、公式の記述の範囲で具体的に落とすと、次のようになります。
第一に、人レベルのAGIを「ゴール」として計画を止めない、という見方です。エッセイはAGIを連続体の一点とし、その先のASIを、いま本格的に考える対象へ移しています。社内の導入計画やベンダー選定で「AGIに届いたら一段落」と置くと、公式の整理とはずれます。一方、到達時期は示されておらず、速い進展が続くことも「十分あり得る」と書いてあるだけで、確約ではありません。いつASIになるかを前提にした投資判断は、この文書からは導けません。
第二に、能力の向上を、より大きなモデルの発表だけで見ない、ということです。効率の改善、推論時の計算、複数エージェントの連携、自分で自分を改良する仕組みでも、進展は進み得ます。学習用の計算資源のように一つの入力だけが頭打ちでも、全体が止まるとは限らない、とエッセイは述べています。日本企業がクラウドやAPIの利用枠、コスト、調達条件を見るとき、「学習の規模が頭打ちなら、現場の能力も頭打ち」とは限らない、という含意があります。逆に、一つの制約が外れたときに能力が急に跳ねる「積み残し」も、公式が注意している点です。
第三に、最先端の能力が伸びなくても、同じ知的作業の単価は下がり得る、という「認知の工業化」です。問い合わせ対応、資料の下書き、社内検索、翻訳、データ整理のような、いまのAIでも一部を担える作業は、効率と計算資源の拡大だけで、より安く、より大量に回せる可能性があります。エッセイは、機械化が定型の肉体労働をコモディティにしたのと同じように、認知作業の標準化と自動化、産業規模のインフラ整備、一部の認知的な成果やサービスの豊富化が進む、と述べています。一方、いまのAIを速さと数だけで増やしても、人の助けなしにはできない作業が残れば、それだけでは完全なAGIにも届かない場合がある、とも書いています。自社の業務を「いまのモデルの延長で量産できる部分」と「まだ人が必要な部分」に分けて見る材料になります。
第四に、複数のAIを同時に使う現場への含意です。エッセイは、多数のAGIを組織や市場のようにまとめる道筋を示しつつ、人数を増やしたときの伸び方はまだはっきりせず、協調の非効率で伸びが鈍る例や、誤情報、操作、談合、ごまかしと告発といった動きが早く出る実験もある、と書いています。日本企業でも、複数のモデルやエージェントを並列に走らせ、役割を分ける使い方は増えています。人数やツールを足すだけで成果が比例して増えるとは限らず、分担の設計、出力の突き合わせ、誤情報への備えが、公式の整理でも論点になっている、と見ておくとよいでしょう。
第五に、評価の問題です。自分で自分を改良する仕組みは、フィードバックが貧弱だと停滞や劣化が起きやすく、人の集団でも評価しにくい領域では、検証の仕組みが追いつかないと遅れ得る、と書かれています。自動で正誤を確認できる作業(計算、一定のコード、形式的な検査)と、人の判断が残る作業(ブランドのトーン、顧客対応の可否、法務や広報の判断)では、自動化の速度が分かれ得る、という読み方ができます。自社でAIの品質を測る指標を置くとき、人がその場で判定しにくい領域ほど、評価の設計そのものがボトルネックになり得ます。
第六に、文書の位置づけです。エッセイはDeepMind Instituteの議論の出発点であり、Googleの公式見解として読むものではない、と明記されています。対外説明や社内の方針に引用するときは、Googleの製品発表や安全方針と、研究者のエッセイ・報告書を分けて扱う必要があります。公式が勧める次の手は、「モデル化し、測り、見通しを立て、繰り返す」ことです。ベンダーの新モデル発表だけでなく、推論コスト、効率、複数エージェントの動き、評価方法の変化を、一次情報で追う、という実務に落とせるでしょう。
Google DeepMindの最近の公式の動きとしては、世界モデル「Genie 4」の一般提供も別記事で整理しています(Gemini APIとGoogle AI Studioでの一般提供、研究プレビュー公開時の解説)。Geminiの更新履歴は、Geminiの最新アップデートで追っています。
出典
- DeepMind Institute「What comes after AGI?」(Tim Genewein氏、2026年11月19日): https://institute.deepmind.com/essays/what-comes-after-agi/
- 技術報告書「From AGI to ASI」(Tim Genewein、Matija Franklin、Alexander Lerchner、Laurent Orseau、Samuel Albanie、Adam Bales、Cole Wyeth、Stephanie Chan、Iason Gabriel、Joel Z. Leibo、Allan Dafoe、Marcus Hutter、Thore Graepel、Shane Legg。arXiv:2606.12683、第3版は2026年11月10日): https://arxiv.org/abs/2606.12683
- Google DeepMind刊行物ページ「From AGI to ASI」(2026年6月12日): https://deepmind.google/research/publications/239142/