平山 大樹 AB通信 運営責任者
AB通信 編集部が、企業・行政の公式発表や決算資料などの一次情報を確認して書いています。運営会社・編集方針
クローラーとは、Web上のページを自動で見つけて内容を取得するプログラムのことです。Googleのクローラーは「Googlebot」と呼ばれます。
- ページがGoogle検索に表示されるには、まずクローラーに見つけてもらう必要があります。
- クロールの状況は、Search Consoleの「クロールの統計情報」レポートや「URL 検査ツール」で確認できます。
- クロール バジェットを気にする必要があるのは、主に大規模なサイトです。多くのサイトでは、サイトマップの更新やリンクの整備で十分です。
この記事は2026年11月1日時点の情報で更新しました。
クローラーとは
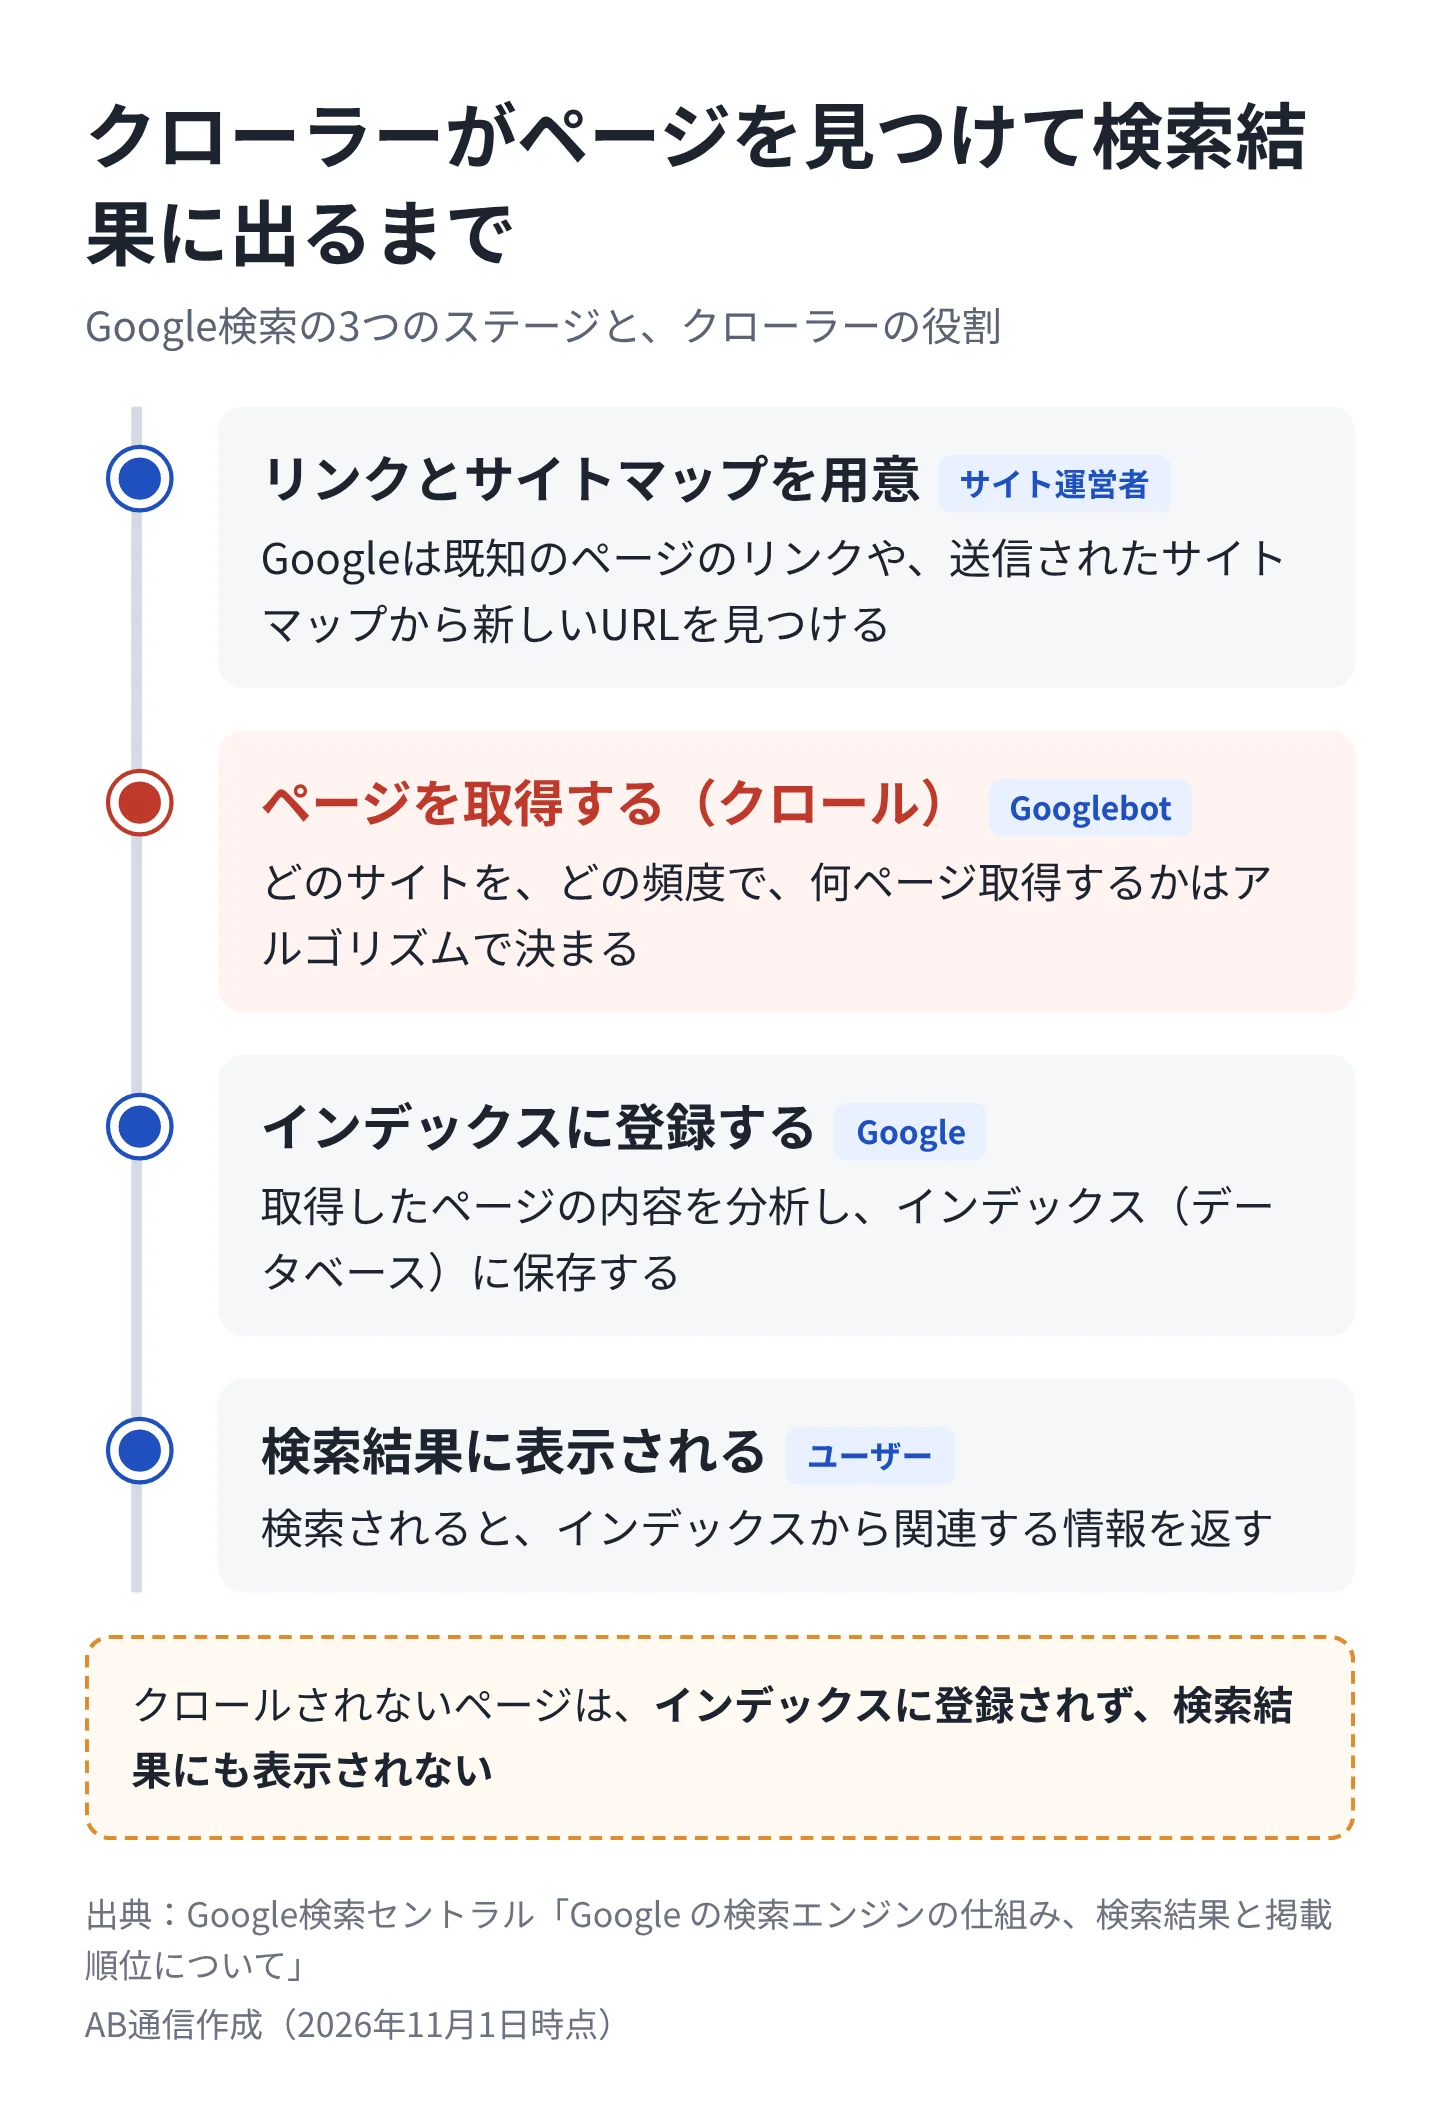
クローラーとは、リンクなどをたどってWeb上のページを見つけ、その内容を取得するプログラムです。ロボット、ボット、スパイダーとも呼ばれます。Googleは、Googlebotがアルゴリズムを使って、クロールするサイト、頻度、各サイトから取得するページ数を決めていると説明しています(Google検索セントラル「Google の検索エンジンの仕組み、検索結果と掲載順位について」)。
検索エンジンとクローラーの関係
Google検索は「クロール」「インデックス登録」「検索結果の表示」の3つのステージで動いています。クローラーが担うのは最初のクロールです。クロールされないページはインデックスに登録されず、検索結果にも表示されません。検索エンジン全体の仕組みは「検索エンジンとは?仕組みと世界・日本のシェア」で解説しています。
Googleの主なクローラー
Googleは、用途ごとに複数のクローラーを公開しています(Google検索セントラル「Google の一般的なクローラー」)。
| 名前 | 主な役割 |
|---|---|
| Googlebot(スマートフォン / パソコン) | Google検索のためのクロール |
| Googlebot-Image | 画像のクロール |
| Googlebot-Video | 動画のクロール |
| Google-Extended | robots.txtで使う制御用のトークン。自社サイトのコンテンツを、Geminiモデルのトレーニングやグラウンディングに使わせるかどうかを管理できる |
Googleは、Google-ExtendedがGoogle検索でのサイトの登録に影響したり、ランキングのシグナルとして使われたりすることはないとしています。
GoogleはAIによる概要(AI Overviews)やAIモードについて、「表示されるための追加の要件はなく、別途特別な最適化を行う必要もありません」と説明しています(Google検索セントラル「AI 機能とウェブサイト」)。サポートリンクとして表示される条件は、インデックスに登録され、スニペットを表示できる状態であることです。AI検索への対応も、まずは通常のSEOの基本を整えることが出発点になります。
クロール バジェットは気にしなくてよい場合がほとんど
Googleがサイトのクロールに使える時間やリソースを「クロール バジェット」と呼びます。Googleのガイドは、主に次のようなサイトを対象としています(Google検索セントラル「クロール バジェットの管理」)。
- 大規模(重複のないページが100万以上)で、1週間に1回程度更新されるサイト
- 中規模以上(重複のないページが1万以上)で、毎日更新されるサイト
頻繁に更新されるページが多くない場合や、公開した日にクロールされている場合は、このガイドを読む必要はないとされています。サイトマップを最新の状態に保ち、インデックスの状況を定期的に確認すれば十分です。
クローラーがサイトに来ているか確認する方法
Search Consoleの「クロールの統計情報」レポート
Googleがサイトをクロールした回数や、サーバーの応答の状況などを確認できます(Search Console ヘルプ「クロールの統計情報レポート」)。
Search Consoleの「URL 検査ツール」
ページごとに、インデックスに登録されているか、前回クロールされた日時などを確認できます(Search Console ヘルプ「URL 検査ツール」)。ページを公開・更新したときは、ここからインデックス登録をリクエストすることもできます。
「site:」検索
Googleの検索窓に「site:example.com」のように入力すると、インデックスに登録済みのURLを確認できます。ただし、Googleは返されるURLのリストは網羅的ではないとしています(Google検索セントラル「検索演算子「site: 」の使い方」)。目安として使いましょう。
クロールされやすいサイトにする方法
1. サイトマップを送信する
サイトマップは、サイト内のページや更新日をGoogleに伝えるファイルです。Search Consoleから送信できます(Google検索セントラル「サイトマップについて」)。
2. クロールできるリンクを使う
Googleがたどれるのは、基本的に「href」属性を持つ「<a>」タグのリンクです(Google検索セントラル「Google の SEO リンクに関するベスト プラクティス」)。JavaScriptのクリック操作だけで移動するリンクは、たどれない場合があります。
3. 内部リンクとアンカーテキストを整える
関連する記事どうしをリンクでつなぐと、クローラーがページを見つけやすくなります。リンクの文字(アンカーテキスト)は、「こちら」ではなく、リンク先の内容がわかる言葉にしましょう。
4. URLをシンプルにする
Googleは、複数のパラメータを含むような複雑なURLは、同じ内容のURLを大量に生み、クロールの問題につながることがあるとしています(Google検索セントラル「Google 検索における URL 構造のベスト プラクティス」)。読みやすく、内容がわかるURLにしましょう。
5. robots.txtを正しく使う
robots.txtは、クローラーにアクセスしてほしくないURLを伝えるファイルです。ただし、ページを検索結果に出さないための仕組みではありません。Googleは、他のページから参照されている場合、クロールせずにURLをインデックスに登録することがあるとして、検索結果に表示させたくない場合はパスワード保護やnoindexを使うよう案内しています(Google検索セントラル「robots.txt の概要とガイド」)。
まとめ
クローラーは、ページを見つけて内容を取得する、検索エンジンの入口となるプログラムです。多くのサイトではクロール バジェットを気にする必要はなく、サイトマップの送信、クロールできるリンクと内部リンクの整備、シンプルなURL、robots.txtの正しい使い方といった基本を押さえれば十分です。Search Consoleで、クロールとインデックスの状況を定期的に確認しましょう。
参考資料
- Google検索セントラル「Google の検索エンジンの仕組み、検索結果と掲載順位について」(2026年11月1日確認)
- Google検索セントラル「Google の一般的なクローラー」(2026年11月1日確認)
- Google検索セントラル「クロール バジェットの管理」(2026年11月1日確認)
- Search Console ヘルプ「クロールの統計情報レポート」(2026年11月1日確認)
- Search Console ヘルプ「URL 検査ツール」(2026年11月1日確認)
- Google検索セントラル「検索演算子「site: 」の使い方」(2026年11月1日確認)
- Google検索セントラル「サイトマップについて」(2026年11月1日確認)
- Google検索セントラル「Google の SEO リンクに関するベスト プラクティス」(2026年11月1日確認)
- Google検索セントラル「Google 検索における URL 構造のベスト プラクティス」(2026年11月1日確認)
- Google検索セントラル「robots.txt の概要とガイド」(2026年11月1日確認)
- Google検索セントラル「AI 機能とウェブサイト」(2026年11月1日確認)