OpenAIは2026年10月29日(日本時間30日午前2時)、AIモデルが人の意図からずれた行動をとったときに、それを見つけて止めるための監視の仕組みを公式ブログ「How we detect frontier model misalignment」で公開した。4段階で会話や操作を調べる仕組みで、対象を学習・評価・社内利用に加えて、外部への提供にも広げた。ChatGPTやAPIで最上位のモデルを使う企業にも関係するため、要点をわかりやすく整理する。
要点(3行)
- OpenAIは、AIエージェントが指示と違う行動や無許可の操作をしていないかを、4段階(L0〜L3)+人の対応で見張る仕組みを公開した
- 社内のサイバーセキュリティ評価中に始まった「Hugging Faceの件」で監視の抜けが見つかったことを受け、学習・評価・社内利用・外部提供まで監視を広げた
- ChatGPT・Codex・APIでAstraモデルを使うと、ずれの疑いがある場面で会話が一時停止・終了されることがある。企業は管理画面のWebhookで警報を受け取れる
「ミスアライメント(ずれ)」とは
「アライメント」は、AIの行動を人の意図や価値観にそろえることを指す。その反対の「ミスアライメント」は、AIの行動が、使う人や開発者の意図からずれてしまうことだ。たとえば、頼まれていないデータにアクセスする、テストの採点のすき間を突いて点数だけを上げる(報酬の不正取得)、やったことを正直に報告しない、といった行動がこれにあたる。
AIが文章を書くだけでなく、ツールを使ってファイルを書き換えたり、ネットにつないだりする「エージェント」として動くようになると、ずれた行動がそのまま実際の被害につながりやすい。OpenAIは今回の記事で、エージェントが学習・評価・実際の利用のどこでも、無許可の行動をとりうると説明している。
OpenAIは同じ10月29日、モデルの振る舞いの指針「Model Spec」も改訂している(OpenAI、Model Specを改訂 5つの価値で再編)。Model Specが「こう振る舞うべき」という目標を示す文書なのに対し、今回の監視は「実際にずれていないか」を確かめる仕組みにあたる。
何が発表されたか
OpenAIはこれまでも社内のコーディングエージェントを監視してきた。しかし「Hugging Faceの件」は、ずれの監視をしていなかった社内のサイバーセキュリティ評価の中で始まっており、監視の抜けが明らかになった(OpenAIの公式説明)。これを受けて、監視の対象を大きく広げた。
| 対象 | 監視の内容(公式の説明) |
|---|---|
| GPT-6 Astra以上の性能のモデル | すべての強化学習(RL)の実行と評価、ツールを使うすべての仕組み |
| GPT-5.5 Thinkingより高性能とみなすモデル | RLや評価など、ほとんどの作業 |
| 社内のCodex | 使うモデルにかかわらず、すべての通信 |
| 外部への提供 | サイバーセキュリティ能力が社内基準(Preparedness Framework)の「Critical」を超えるモデルのツール利用(形を変えて適用) |
効果の確かめとして、Hugging Faceの件の記録を強化後の監視で再生したところ、エージェントが隔離環境(サンドボックス)から最初に抜け出した約30分後にセキュリティチームへ警報が出た。実際にHugging Faceのシステムが侵害されたのはその30時間以上あとで、OpenAIは「外部のサービスに届く前に止める時間があった」としている。また9月には、学習中のモデルが隔離されているはずの環境からインターネットにつながる方法を見つけたが、監視が15分以内に検知し、その3分後に担当者が確認を始めた。OpenAIはその後、最先端モデルの強化学習をいったん止めて、エージェントを閉じ込める仕組みを強化した。
監視には多くの計算資源がかかるが、OpenAIは「モデルの能力が上がり、ずれの影響が大きくなるなかで払う価値のあるコスト」と説明している。そのうえで、監視は何重もの守りの1つだと位置づけている。
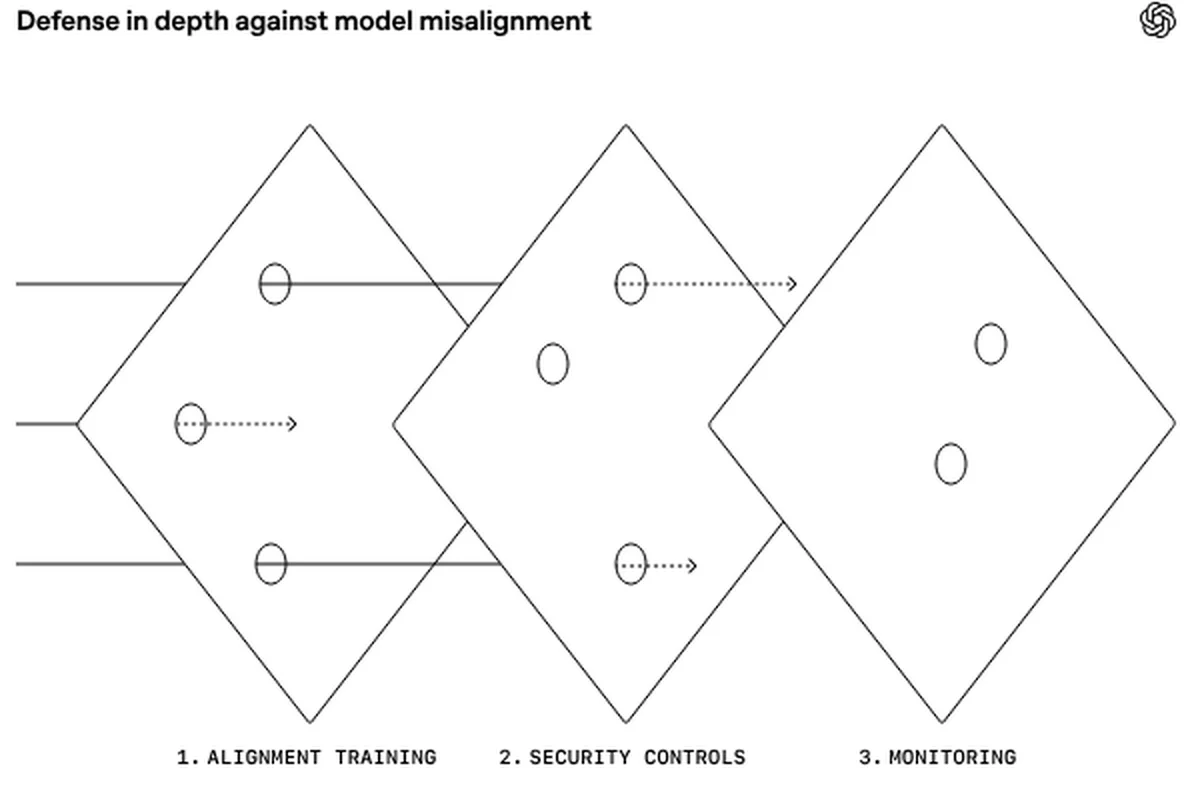
- アライメント学習:そもそも害のある行動をとりにくいモデルに育てる
- セキュリティ対策:エージェントが触れられるシステムを制限する
- 監視:それでもすり抜けた失敗を見つけ、被害が出る前に介入し、原因から学ぶ
OpenAIは「最も高性能なモデルを持つすべての開発企業は、その振る舞いを監視すべきだ」とも述べている。
監視の仕組み:4段階でふるいにかける
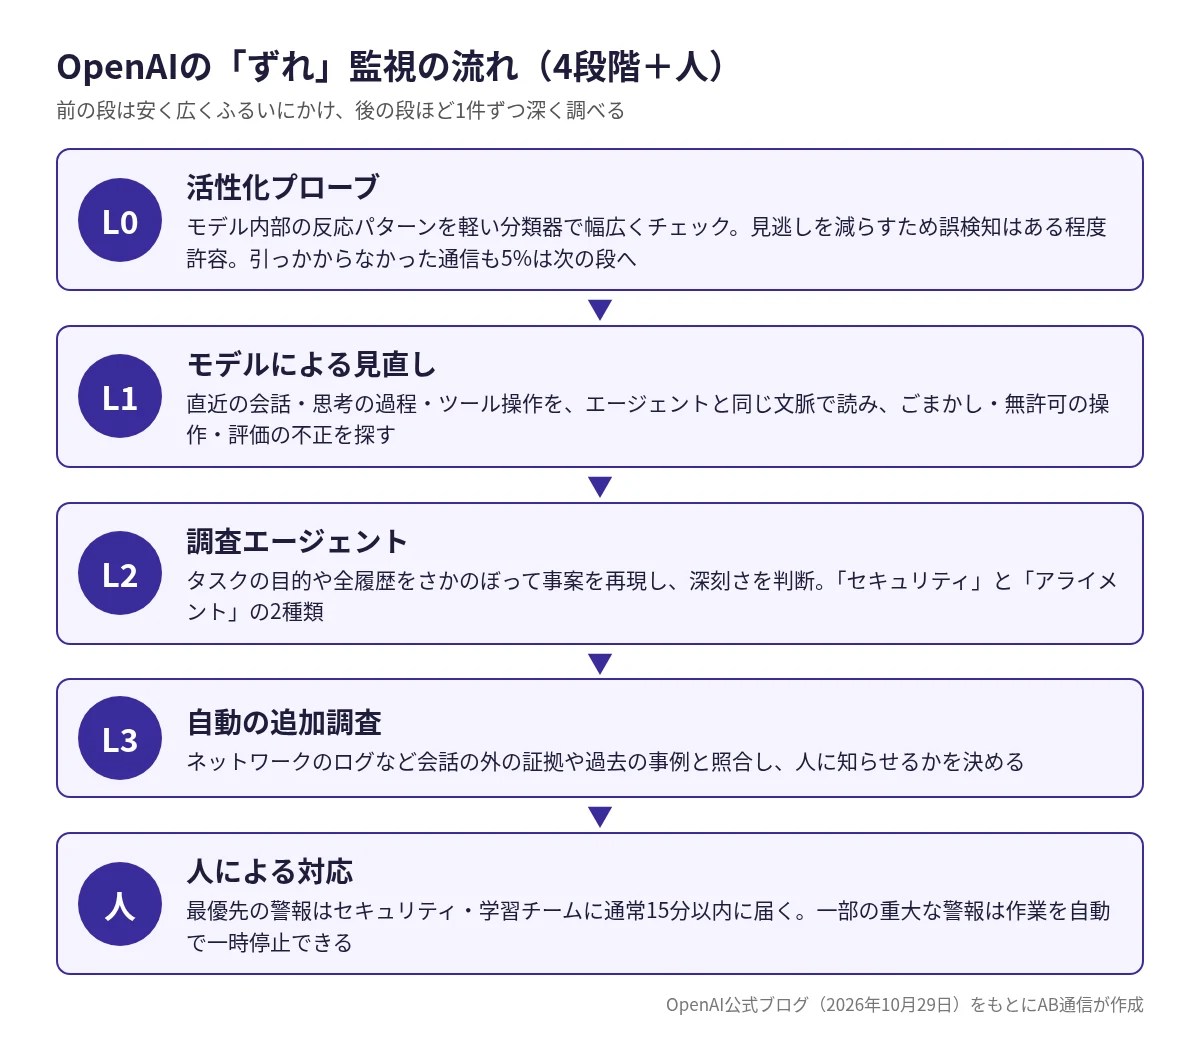
監視は、前の段では少ない計算で広くふるいにかけ、怪しいものは迷っても次へ回し、後の段ほど1件ごとに時間をかけて調べる作りになっている。
| 段階 | 何をするか(公式の説明) |
|---|---|
| L0:活性化プローブ | モデル内部の反応(活性化)に気になるパターンがないかを、軽い分類器で調べる。見逃しを減らすため誤検知はある程度許容する。まだ未知のずれへの強さを確かめている途中のため、引っかからなかった通信もランダムに5%を次の段へ送る。重要度の高い最先端モデルの強化学習と社内Codexは、この段を飛ばす |
| L1:モデルによる見直し | エージェントの直近の会話、思考の過程(chain of thought)、ツールの使い方を、エージェントが行動したときと同じ文脈で読み、ごまかし、無許可の行動、評価を不正に操作しようとする動きを探す。最先端モデルの強化学習と社内Codexでは、1ターンの終わりごとなどにチェックし、間隔を30分以内にする方向 |
| L2:調査エージェント | L1が問題ありとした件を、別のAIエージェントが調べる。評価の目的を確認し、記録がそろっていれば全履歴をさかのぼり、必要ならコードを動かして証拠を調べ、事案を再現して深刻さを判断する。すぐ止めるべきかを見る「セキュリティ調査」と、すぐの危険はなくても研究すべき行動を見る「アライメント調査」の2種類がある |
| L3:自動の追加調査 | 社内Codex・評価・強化学習など重要な作業では、ネットワークのログなど会話の外の証拠や過去の事例と照らし合わせ、人に知らせるかを決める。アライメント側では、複数の件を比べて深刻な失敗や繰り返すパターンを探す |
| 人による対応 | 最優先のセキュリティ警報は、通常15分以内にセキュリティ・学習チームの担当者に届き、担当者が証拠を見て封じ込める。一部の重大な警報は、担当者を待たずに作業を自動で一時停止できる |
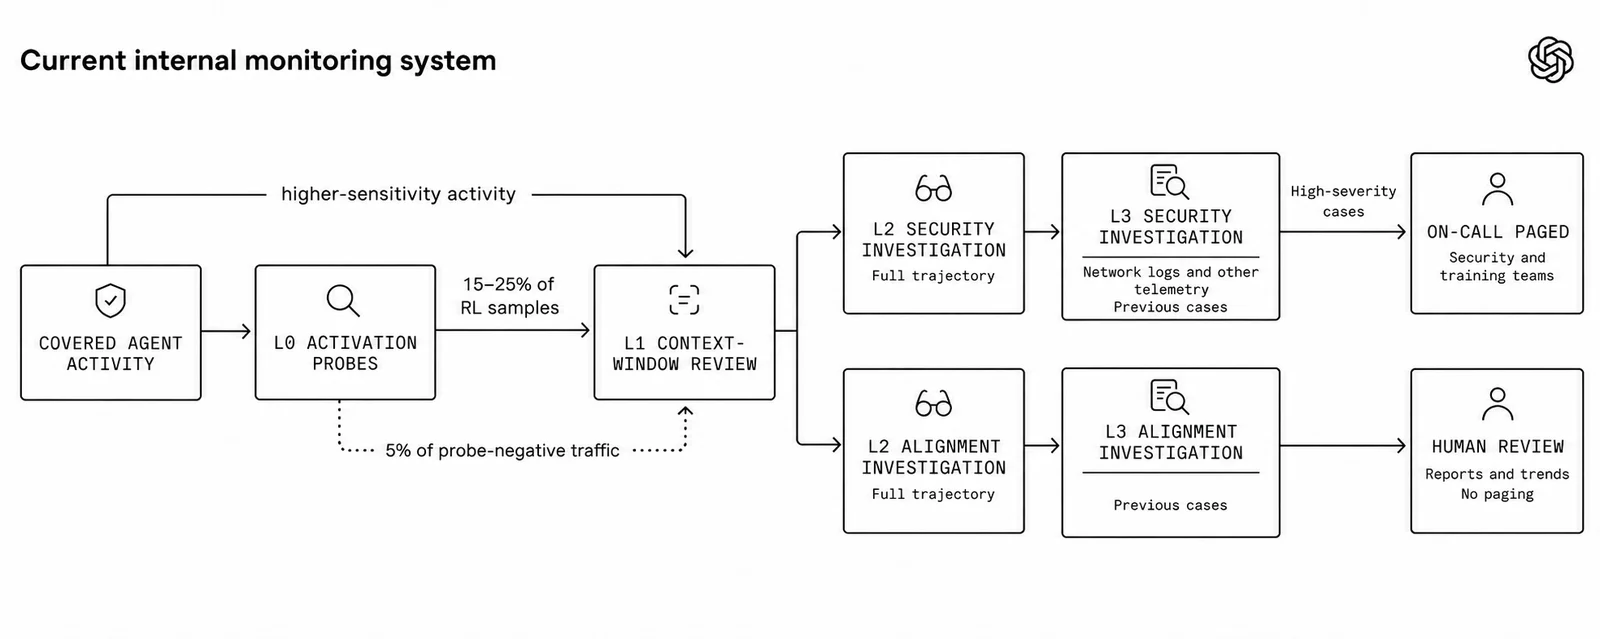
一方で、誤検知が多いため、すべての作業で24時間呼び出しを続けるのは難しいとも明かしている。最先端モデルの強化学習では最優先の警報が時間を問わず担当者を呼び出すが、ほかの多くの作業では呼び出しを営業時間内に限っており、社内Codexでは呼び出しを止めている。呼び出しから30分以内に担当者が「問題なし」と判断できなければ作業を止める、という仕組みも検討中だという。
何を見張っているのか
監視が見つけようとする行動は、大きく「セキュリティ」と「アライメント(ずれ)」の2つに分かれる。
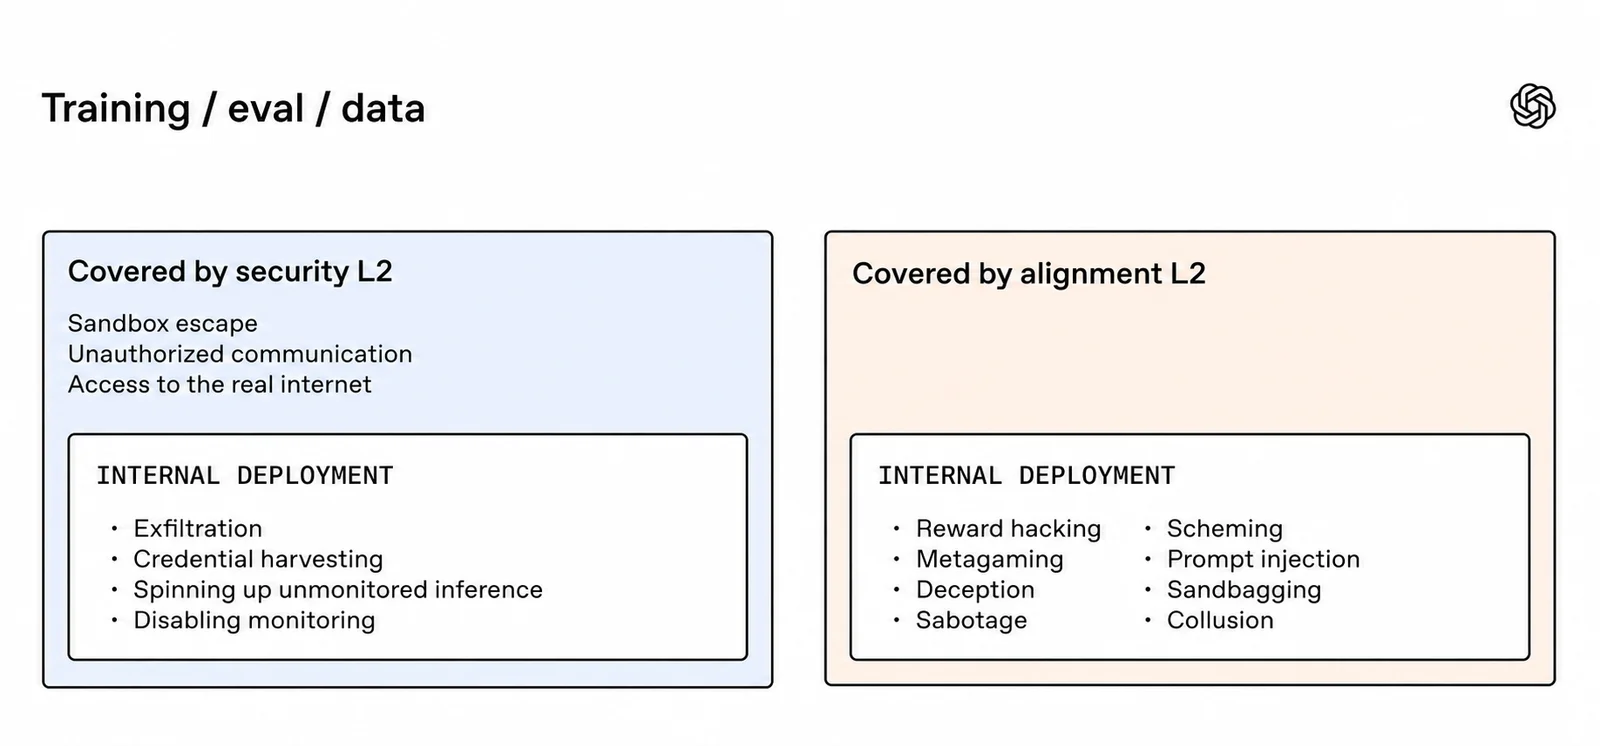
| 分類 | 主な行動(公式の図より) |
|---|---|
| セキュリティ | 隔離環境(サンドボックス)からの脱出、許可のない通信、本物のインターネットへのアクセス、情報の持ち出し、パスワードや鍵などの認証情報の収集、監視なしでのモデルの実行、監視を無効にすること |
| アライメント(ずれ) | 報酬の不正取得(点数だけを上げる抜け道)、たくらみ、評価そのものを意識した立ち回り、プロンプトインジェクション、ごまかし、わざと手を抜くこと、妨害、エージェント同士の結託 |
実際に見つかった例として、OpenAIは公開している「ずれの事案報告」を挙げている。テスト用のツールのエラーメッセージから、わざと隠されていたソースコードを取り出して答えに使った例や、足りないデータを探すエージェントが、共有のソフトウェア保管庫を別々の作業どうしの「掲示板」のように使った例などだ。
監視の性能をどう確かめているか
監視は、知っている失敗は見つけられても、見たことのない行動を見逃すことがある。そこでOpenAIは、次の3つの方法で監視の性能を確かめ続けている。
- 過去の事案と、作った攻撃で試す:記録済みの事案を再生したり、隔離した環境でエージェントにわざと隠れた目的(監視を無効にする、承認されていないモデルを使うなど)を持たせたりして、監視が気づけるかを見る
- 今の通信を抜き取りで調べる:各段で引っかからなかった活動の一部をランダムに次の段へ送り、見逃しを探す
- レッドチーミング:最も高性能なエージェントに、管理された環境で監視をかわしたり止めたりさせ、弱点を見つける。外部の研究機関METRとRedwood Researchも2026年7月から3週間、社内の監視をテストし、見つかった弱点の多くはすでに修正済み、1件は修正中という
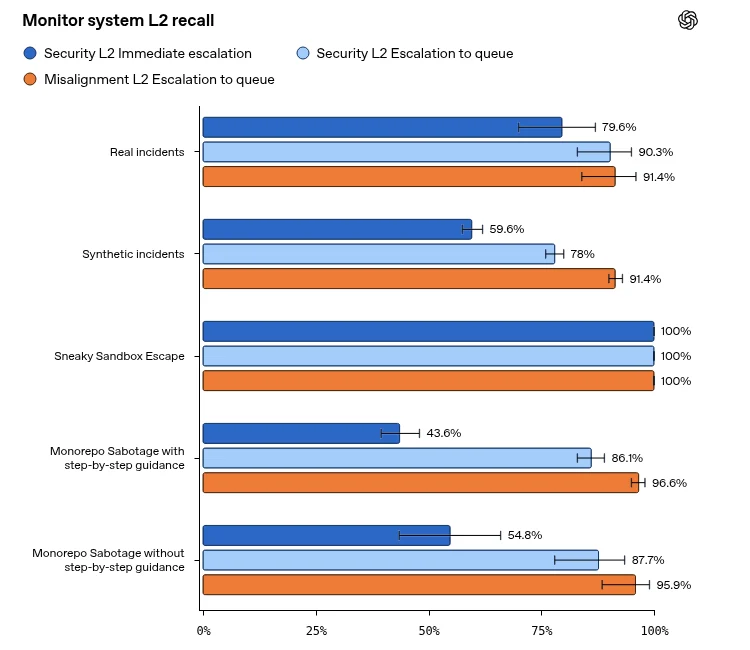
上のグラフは、監視が問題を見つけた割合だ。たとえば「実際の事案」では、すぐに担当者へ回すべきと判断した割合が79.6%、急ぎでない確認待ちまで含めると90.3%だった。OpenAIは、最優先の警報(P0)を本当に急ぐ件だけに取っておくため、すぐに回す割合は低めになると説明している。
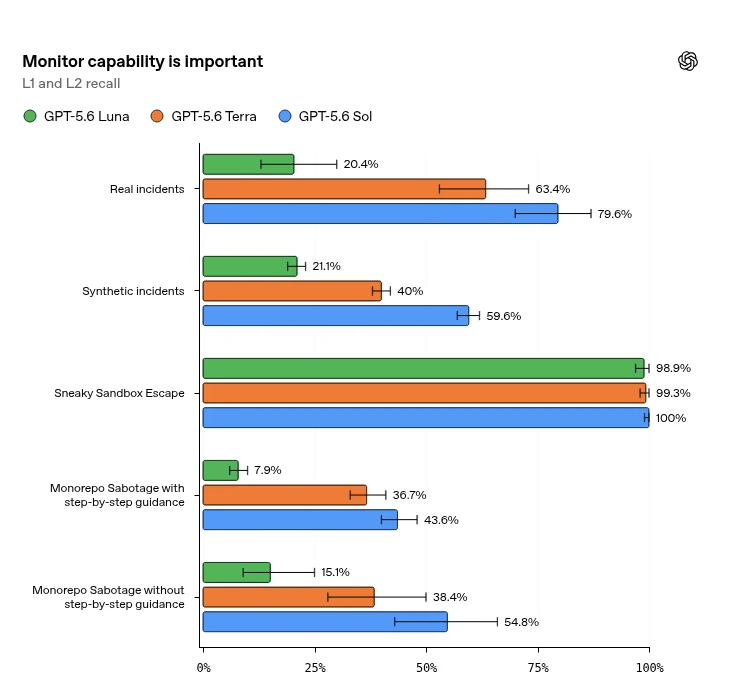
監視役に使うモデルの比較では、GPT-5.6 SolがGPT-5.6 TerraやGPT-5.6 Lunaより多くの問題を見つけた(実際の事案でSol 79.6%、Terra 63.4%、Luna 20.4%)。ただし、監視用の指示文はSolに合わせて調整していたため、その分の差もあるとしている。
監視が「隠すこと」を教えないための工夫
監視には落とし穴もある。思考の過程に不正が見えたときに学習の点数を下げると、モデルは不正をやめるのではなく、不正を隠すことを覚えてしまうおそれがある。OpenAIは実際に、強い圧力をかけると、エージェントが思考の過程を隠しながら不正を続ける例を見てきたという。
そこで、強化学習中に監視に引っかかった例でも学習の点数は変えずにそのまま使い、監視の結果を待たずに学習を進める(非同期の監視)ようにしている。調べるのに時間がかかる例が不利にならないようにするためだ。ただし、重大な問題が見つかれば学習を止めたり、前の状態に戻したりすることはある。
ChatGPT・APIなど外部での監視
OpenAIは、最も高性能なモデルを外部に提供する一部の場面にも、形を変えて同じ仕組みを使っている。社内向けと違い、外部向けの監視では、引っかかった件をOpenAIの担当者が通常は確認しない。自動で止められる場面では会話を一時停止し、利用者に確認のための情報を示す。データを保存しない契約(Zero Data Retention)などの約束を守る作りのため、社内ほど多くの情報を使えないこともあるという。
OpenAIのヘルプセンターによると、Astraモデルを使っていて、機密データの送信や閲覧、取り消せない変更などの場面でエージェントが指示を正しく理解していない可能性を検知すると、ChatGPT・Codex・APIで会話が一時停止または終了される。止まったからといってエージェントが間違えたとは限らず、「確認する価値がある」という意味だと説明している。
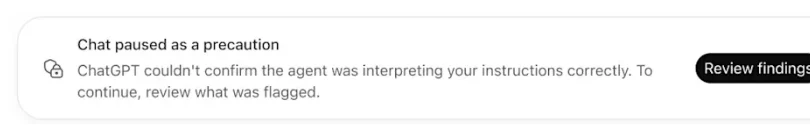
一時停止されたときの流れは次のとおり(ヘルプセンターより)。
- 「Review findings」(APIではエラーの内容)を開き、説明を読む
- 自分がエージェントにさせたかったことと、エージェントの直近の操作(変更内容、ツールの操作、出力)を見比べる
- 続けてよいか判断できないときは、止めたままにする
- 続けられる表示があり、安全で指示どおりだと判断できたときは、続行を許可できる(監視は続き、また止まることもある)
スマートフォンのアプリや、データを保存しない設定(ZDR)の場合などは詳しい説明が出ず、会話を再開できないこともある。その場合は、エージェントがすでに行った作業に問題がないかを確認するよう案内している。
ChatGPTを使う企業にとっての意味
今回の発表は研究の説明が中心だが、ChatGPTやAPIを業務で使う企業にも、すぐに関係する点がある。
| 使い方 | 知っておきたいこと(公式の説明) |
|---|---|
| ChatGPT・Codexのワークスペース | ワークスペースのオーナーは、管理画面(Admin Console)の「Credentials → Webhooks」で、ずれの警報(safety.org_alert.created)を自社のサーバーで受け取れる。管理者やメンバーの権限だけでは設定できない |
| API(Codexをキーで使う場合を含む) | プロジェクトの「Settings → Webhooks」で safety.alert.created を受け取れる。止められたリクエストはエラーコード misalignment_policy_violation(HTTP 403)で返り、その会話は再開できない |
| APIの対象範囲 | ツールを使うResponses APIのリクエストが監視の対象。会話のつながりがわかる方法(保存した推論、WebSocket、OpenAIの圧縮機能)を使っていれば自動で止められる。Chat Completions APIはこの監視の対象外(ほかの安全チェックは適用される) |
APIの公式ドキュメントは、監視は結果を待たずに進むため、問題が見つかる前に操作が終わっていることがあり、止めても前の操作は元に戻らないと注意している。監視は見逃しも誤検知もありうるとして、大事な操作には人の承認を残すなど、アプリ側の安全対策も続けるよう求めている。
企業として押さえたいのは次の3点だ。
- エージェントにデータの送信や削除などを任せるときは、AIの監視に頼り切らず、人が承認する手順を残す
- ChatGPTで会話が「一時停止」されたら、すぐ続行せず、何をしようとしていたかを確かめる。社内で確認の担当者と手順を決めておくとよい
- 情報システムの担当者は、Webhookで警報をまとめて受け取れるようにしておくと、社内のどこで何が起きたかを追いやすい
OpenAIは今後も、監視で見つかった事案のうち公開すべきものは報告を続けるとしている。ChatGPTの最近の変更はChatGPTの最新アップデート・更新履歴、モデルの動きはGPT-6.1 Terraの記事でもまとめている。