平山 大樹 AB通信 運営責任者
AB通信 編集部が、企業・行政の公式発表や決算資料などの一次情報を確認して書いています。運営会社・編集方針
この記事の要約
Anthropicは11月2日、AIの回答が「本当にそのモデルから出たものか」を暗号で証明する試作システム「FlashProve」を公開しました。モデルの重み(中身)は見せないまま、回答ごとに証明ファイルを付け、受け取った側がCPUで確かめられます。4,000億パラメーターのLlama 4 Maverickで、H100 1枚とCPU 24コアを使い、毎秒約110トークンで動いたとしています。高速化の改良はClaudeが作ったと説明しています。研究段階の試作で、コードや証明はオープンソース(Apache 2.0)で公開されています。
出典:Anthropic公式「Progress on provable inference for large language models」(記事末の「出典」に一覧)
「どのモデルが答えたか」を証明する
Anthropicのフロンティア・レッドチームは11月2日、Progress on provable inference for large language modelsという研究記事で、FlashProveを発表しました。
APIなどでAIを使うとき、利用者には、返ってきた回答が約束どおりのモデルで作られたのかを確かめる方法がありません。間に入る業者がこっそり安いモデルに差し替えたり、攻撃者が出力を書き換えたりしても、外からはわかりにくいのが実情です。FlashProveは、ゼロ知識証明の一種であるzkSNARKという暗号技術を使い、「この回答は、公開された指紋(コミットメント)に対応する重みのモデルが作った」ことを、重みを見せずに証明します。
しくみは3ステップ
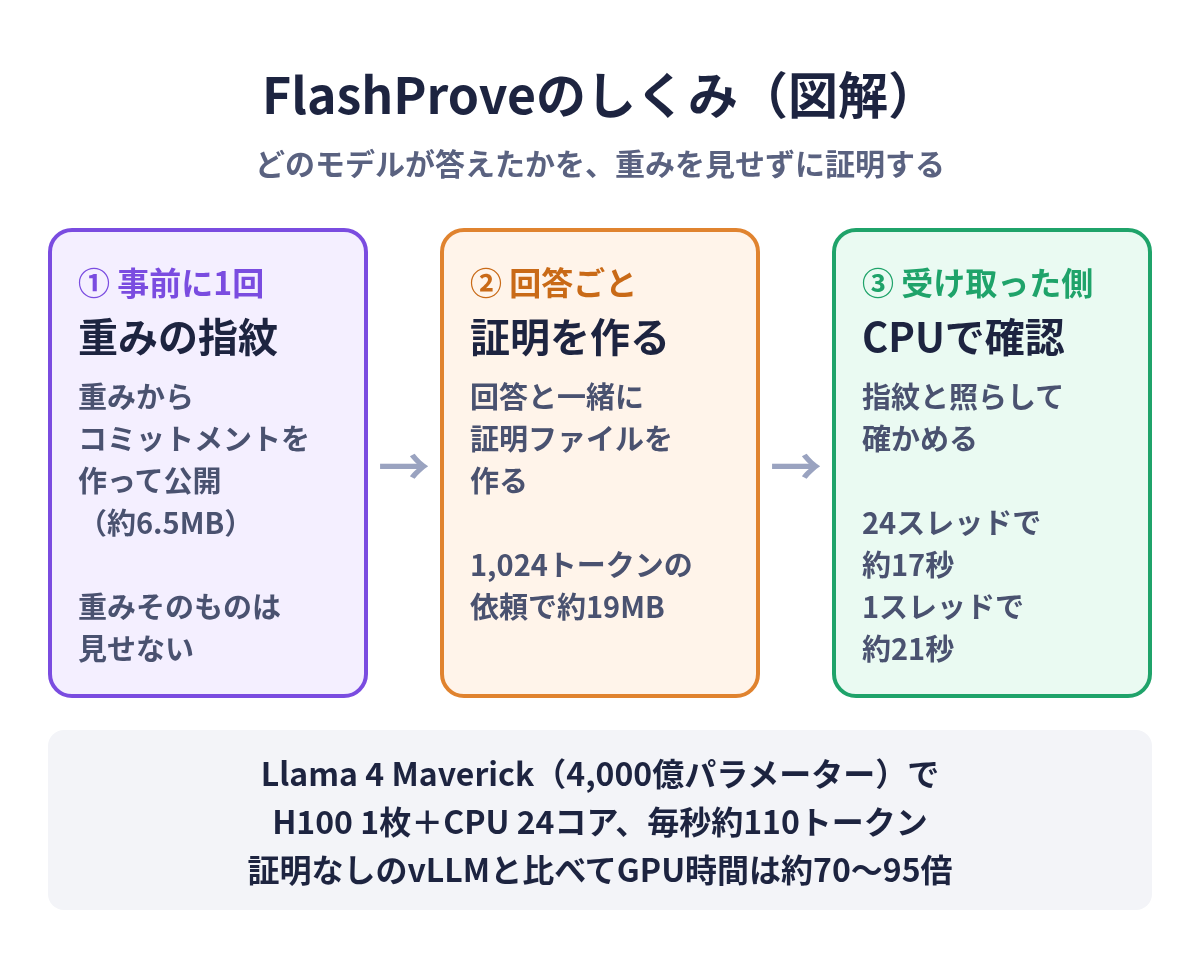
- ① 事前に1回:モデルの重みからコミットメント(指紋のようなもの)を作って公開します。作るのに約39分かかり、1つで約1,600万件の依頼に使えます。利用者がダウンロードするのは約6.5MBです。
- ② 回答ごと:モデルが回答を作るときに、あわせて証明ファイルを作ります。1,024トークンの依頼で約19MB(18.78MB)です。
- ③ 受け取った側:証明をコミットメントと照らして確かめます。24スレッドのCPUで約17秒、1スレッドでも約21秒です。
隠せるのは重みで、モデルの構造(アーキテクチャ)は隠しません。
実用に近い速さまで縮めた
これまでの研究では、証明つきの推論は桁違いに遅いものでした。Anthropicが比べた先行システムのVerInfは、1,000トークンに14.3時間かかり、証明は93.6GBでした。
| 項目 | FlashProveの数字 |
|---|---|
| 試したモデル | Llama 4 Maverick(4,000億パラメーターのMoE、1トークンあたり約170億パラメーターを使用、4ビット) |
| 使った機材 | H100 1枚+CPU 24コア |
| 速さ | 毎秒約110トークン |
| 証明なしとの比較 | GPU 1枚あたりで、24件の処理にvLLMの約72倍(実行ごとに66〜77倍)、vLLMの負荷が最も高いときと比べると約94倍の時間 |
| 証明ファイル | 1,024トークンの依頼で18.78MB |
| 確認にかかる時間 | 24スレッドで約17秒、1スレッドで約21秒 |
| 事前の準備 | コミットメント作成に約39分。約1,600万件の依頼に使える |
| 24件(各1,024トークン)をまとめて処理 | 約223秒 |
vLLMは、広く使われているオープンソースの推論ライブラリです。Anthropicは全体として、証明なしで動かす場合のGPU時間の約70〜95倍だとまとめています。
Anthropicによると、推論向けのzkSNARKの改良はClaudeが作りました。Claudeは最適化が得意な一方、大きく複雑なシステムでは評価しにくい判断をすることがあるため、安全性についての主な主張を、形式検証の言語Leanで確かめられる形にして公開したとしています。
公開されたもの
FlashProveは研究段階の試作として、次のものが公開されています。ライセンスはApache 2.0です。
- 今回の研究記事
- 技術レポート
- プロトコルの仕様書(Claudeが書いたもの)
- 実行できるコード:証明を作るプログラム(プルーバー)と、2つの検証プログラム(速いC++版と、正しさが証明されたLean版)
- 主な数学的な主張についてのLeanの証明と、それを確かめやすくする可視化ツール
試したLlama 4 Maverickの重みは含まれていません。Metaのライセンスのもとで、Hugging Faceから各自が入手する形です。
使い道と限界
Anthropicは使い道として、AI開発のペースを規制・管理する仕組みでの確認、推論サーバーが乗っ取られたときの改ざんの検出、特定のモデルで一定の量の作業をしたことの証明、安全と認められたモデルだけが提供されているかの確認などを挙げています。
一方で、限界もはっきり書いています。
- 速いC++版の検証プログラムなど、実際に使うコードには形式的な保証がない(テストではLean版と結果が一致)
- 証明の対象は、重みを整数にした版のモデルで、いつも一番確率の高い語を選ぶ生成(グリーディ・デコーディング)が前提
- MoE(専門家混合)型のモデルを前提にしていて、モデルの構造は隠さない
- 証明を作る時間などから重みの情報が漏れるサイドチャネル攻撃は、今回の対象外
- 扱える文脈(コンテキスト)は1,024トークンまで
Claudeの回答に証明が付くといった、製品への導入については、記事では触れていません。なお、Anthropicは、2026年9月30日までにモデルの出力を特定の重みに結びつけて証明する技術の試作を作る目標を掲げていました。この目標は、推論の通信に署名し、信頼できるサーバーで推論を計算し直す別のプロジェクトで達成したとしています。今回のFlashProveは、同じ目的を別の方法で追う研究です。
出典
- Progress on provable inference for large language models(Anthropic、2026年11月2日、2026年11月4日確認)
あわせて読みたい
- AIの透かし、主要5社を比較 OpenAI・Google・Anthropic・xAI・Metaの対象と確かめ方【2026年11月】
- Claude、見えない文章の透かしを旧モデルにも 11月3日からOpus 4.7などと報道
- Claudeの最新アップデート・更新履歴(公式リリースノートまとめ)
更新履歴
- 2026年11月4日:初版