平山 大樹 AB通信 運営責任者
AB通信 編集部が、企業・行政の公式発表や決算資料などの一次情報を確認して書いています。運営会社・編集方針
この記事の要約
robots.txtで「AI学習に使わないでほしい」と各社にまとめて伝える共通の書き方「User-agent: __usage_ai-training」を、Xが自社のrobots.txtに書き入れました。もとになったIETFの提案文書は10月30日に出た個人ドラフトで、まだ正式な標準ではありません。この書き方は巡回(クロール)を止めるものではなく、GoogleとMicrosoftは検索結果への掲載にも影響しないとしています。「User-agent: *」のグループは学習の拒否とはみなされず、守るかどうかは各社次第です。Microsoftは2027年2月1日から、Googleは2027年中に対応する予定です。
出典:IETFの提案文書、X・Google・Microsoft・OpenAIの公開情報、Search Engine Journal・heiseの報道(記事末の「出典」に一覧)
Xのrobots.txtに共通の書き方が入った
Xのrobots.txtには、11月3日時点で次のグループが書かれています。直前のコメントでは、IETFの提案文書にもとづく共通の「AI学習の意思表示」で、Microsoft、Google、OpenAI、Anthropicが従うものだと説明しています。あわせて、これはクローラーではなく利用方法を示すトークンで、巡回してよいかは変えず、「User-agent: *」には当てはまらないとも書いています。
# Shared AI training preference (IETF draft-kelley-aipref-training-preference-signal),
# honored by Microsoft, Google, OpenAI, and Anthropic. This is a usage policy
# token, not a crawler: it does not change crawl access, and `User-agent: *`
# never matches it.
User-agent: __usage_ai-training
Disallow: /
Internet Archiveの記録では、10月30日14時31分(日本時間)の時点のXのrobots.txtにはこのグループがなく、10月31日11時3分(同)の記録には入っています。各社の発表が出た10月30日(米国時間)から間もなく書き加えたとみられます。
ただし、コメントにある「各社が従う」は、各社の発表では「これから対応する」段階です(後述)。Xのrobots.txtは、もともと末尾の「User-agent: *」のグループで、名前を挙げていないクローラーの巡回を「Disallow: /」で断っています。今回のグループは、これとは別に学習についての意思を示すものです。
もとになった提案文書:IETFの個人ドラフト
もとになっているのは、IETF(インターネットの技術標準を話し合う団体)に出された提案文書「Machine-Readable Training Preference Signal」(draft-kelley-aipref-training-preference-signal-00)です。著者はAnthropicのケビン・ケリー氏で、公開日は2026年10月30日、有効期限は2027年5月3日です。IETFの文書管理システム(Datatracker)では「個人のインターネットドラフト」と表示され、「IETFが承認したものではなく、標準化の手続きのうえで正式な位置づけはない」と注記されています。AIの利用方法の意思表示を話し合うAI Preferences(AIPREF)作業部会への提案で、内容が変わったり、別の文書に置き換えられたりする可能性があります。
提案文書は、robots.txtに新しい命令や書式を足しません。User-agentの行に、クローラーの名前の代わりに用途を表す「ポリシートークン」__usage_ai-trainingを書き、その下のAllowとDisallowで、どのパスを学習に使ってよいかを示します。対象の「AI学習」は、作業部会の用語の定義にもとづき、生成AIモデルの学習(モデルのパラメーターを変えること)を指し、分類やランキングなど生成以外の用途にだけ使うモデルは含みません。
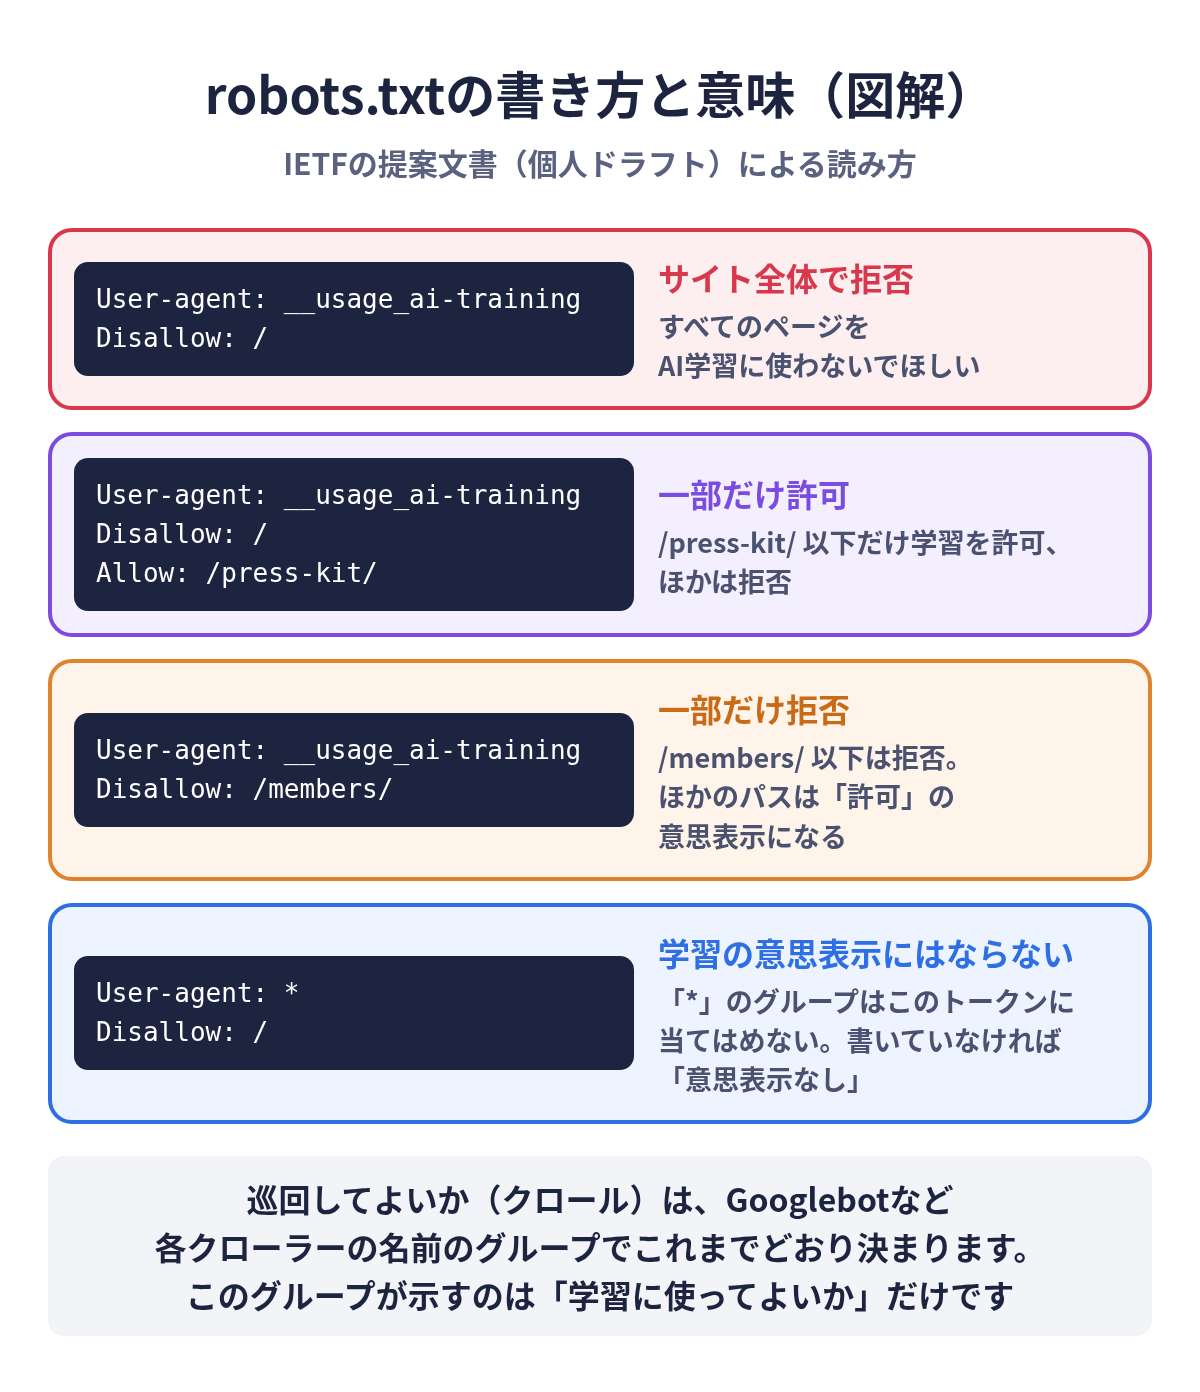
押さえておきたい4つの点
- 巡回は止めない:提案文書は、このトークンは「巡回の動きを指示するものではない」としています。巡回を制限したいなら、各クローラーの名前のグループを使うよう書いています。一方で、学習のためだけに巡回する事業者が、拒否されたページを取りに行かないことは認めています
- 「User-agent: *」では拒否にならない:提案文書は、「*」のグループをこのトークンに当てはめてはならないと定めています。__usage_ai-trainingのグループがないrobots.txtは「意思表示なし」と扱われます。提案者のケリー氏はIETFのメーリングリストで、今あるrobots.txtはどれも意思表示をしていないことになると説明しています
- 一部だけ拒否すると、ほかは「許可」の意思表示になる:パスが許可されていれば「学習に賛成」、拒否されていれば「反対」と読む決まりのため、たとえば/members/だけを拒否すると、ほかのパスは学習を許可したことになります
- 強制力はない:robots.txtはもともと、従うかどうかを読み手に任せる仕組みです。提案文書も、事業者とサイトのあいだの個別の契約は、この意思表示より優先されうるとしています
各社の対応:まだ始まっておらず、時期もばらばら
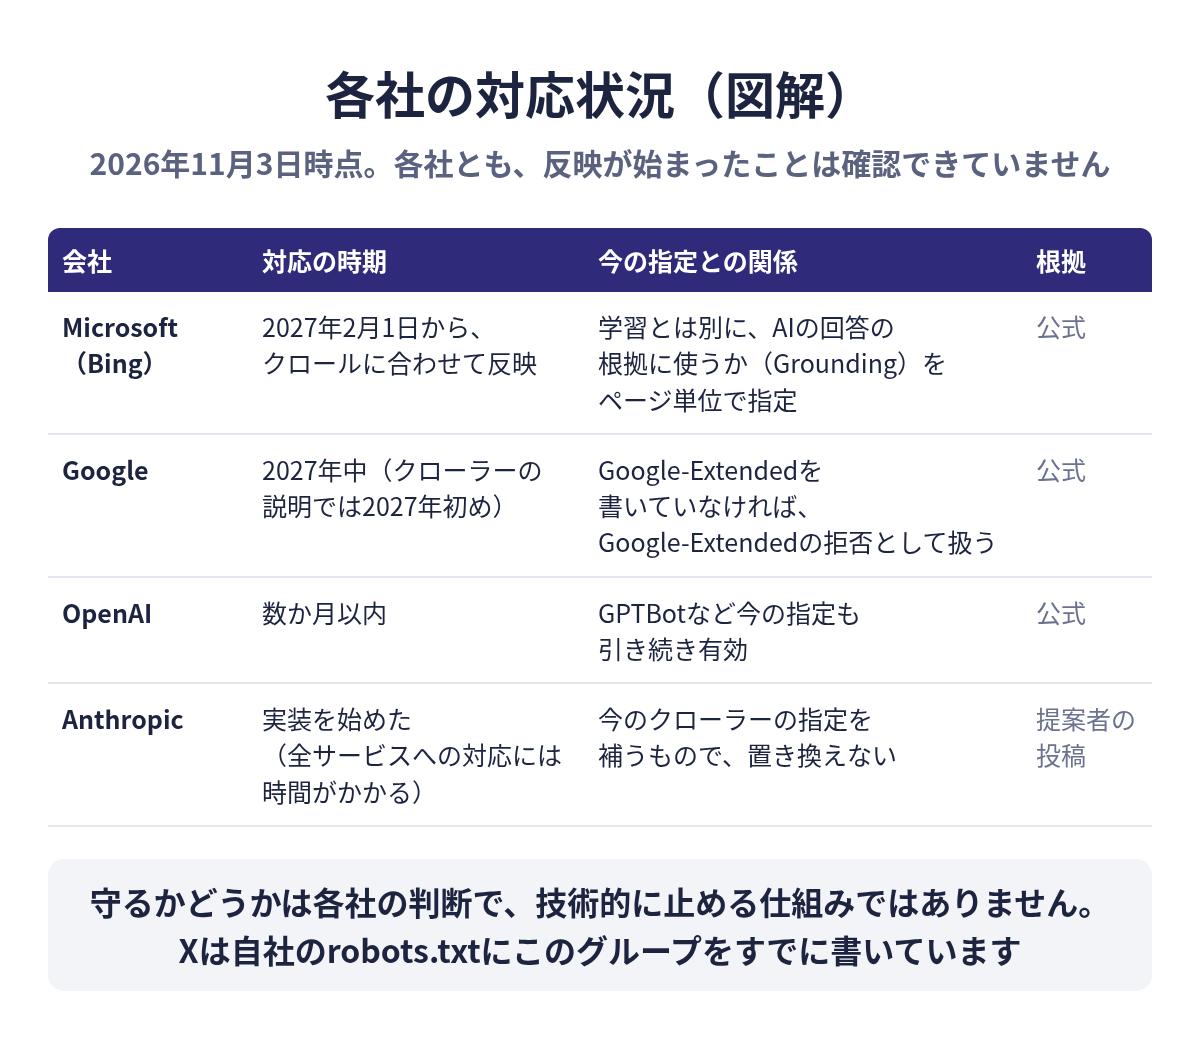
| 会社 | 対応の時期 | 内容(公式の出典) |
|---|---|---|
| Microsoft(Bing) | 2027年2月1日から、クロールに合わせて反映 | robots.txtの__usage_ai-trainingで学習の可否を指定でき、ページ単位でも上書きできる。AIの回答の根拠に使うか(AI Grounding)はページ単位の別の指定にする。どちらもBingの検索結果に載る条件は変えない(Bing公式ブログ) |
| 2027年中(クローラーの説明では2027年初め) | このトークンで学習を拒否し、Google-Extendedを個別に書いていなければ、Google-Extendedを拒否したものとして扱う。Google-Extendedは、Google検索への掲載や順位に影響しない(Google検索セントラル ブログ、Googleのクローラーの説明) | |
| OpenAI | 数か月以内 | 共通の指定に従うと発表。今のrobots.txtでの指定(GPTBotなど)を置き換えるものではなく、引き続き有効(OpenAI公式) |
| Anthropic | 未定 | 提案者のケリー氏が、Anthropicは実装を始めたと投稿。全サービスで対応するには時間がかかり、今のクローラーの指定を置き換えるものではないとしている(IETFのメーリングリスト)。Anthropicとしての公式発表は確認できていない |
Googleのブログは「2027年に、ほかのAI事業者とともに対応することを目指す」としています。heiseも、Googleが2027年から対応すると報じています。Googleのクローラーの説明ページには、__usage_ai-trainingによる共通の意思表示に「2027年初め」に対応する予定との注記があります。
検索への影響について、Googleは今回の共通の指定そのものが検索に影響するかどうかを直接は書いていません。共通の指定はGoogle-Extendedの拒否として扱われ、そのGoogle-Extendedは「Google検索への掲載に影響せず、順位づけにも使わない」と説明しています。Microsoftは、新しい指定は「Bingの検索結果に載る条件を変えない」としています。
Search Engine Journalは、GoogleとMicrosoftで、拒否したときに及ぶ範囲が違う点を指摘しています。Googleでは学習とAIの回答の根拠(グラウンディング)への利用がGoogle-Extendedにまとまっているのに対し、Microsoftでは学習とグラウンディングを別々に決められます。
robots.txtの書き方の例
サイト全体で学習を拒否する場合は、次の2行です。何も書かなければ「意思表示なし」で、Microsoftは学習を許可したものとして扱います。
User-agent: __usage_ai-training
Disallow: /
一部のパスだけ学習を許可する場合は、提案文書の例のようにAllowを足します。
User-agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
各社の対応がそろうまでは、今の事業者ごとの指定と並べて書いておく形が考えられます。各社とも、今の指定は引き続き有効だとしています。
# 共通の書き方(AI学習の意思表示)
User-agent: __usage_ai-training
Disallow: /

# 事業者ごとの学習向けの指定(引き続き有効)
User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: ClaudeBot
Disallow: /
サイト運営者が判断するときのポイント
ここまでの公式の情報から、判断の材料をまとめます(AB通信による整理です)。
- 何を断りたいのかを分ける:このグループが示すのは「学習」だけです。検索への掲載や、AIの回答で引用されるかどうかは別の指定で決まります。Microsoftは、回答の根拠への利用を断るとAIでのブランドの露出が減ると注意しています
- 「User-agent: *」だけでは足りない:すべてのクローラーを止めているつもりでも、学習の意思表示にはなりません。学習を断るなら、__usage_ai-trainingを名指しで書く必要があります
- 一部だけ拒否するときは、ほかが「許可」になる:拒否したいパスだけを書くと、残りは学習への賛成と読まれます。意図どおりかを確かめましょう
- 今の指定は消さない:対応の時期は各社で違い、まだ反映は始まっていません。GPTBotやGoogle-Extendedなど今の指定も残しておくのが無難です
- 正式な標準ではない:もとの提案文書は個人ドラフトで、書き方や意味が変わる可能性があります。守るかどうかも各社の判断です
出典
- Machine-Readable Training Preference Signal(draft-kelley-aipref-training-preference-signal-00)(IETF、2026年10月30日)
- [ai-control] New draft: draft-kelley-aipref-training-preference-signal-00(IETF ai-controlメーリングリスト、2026年10月30日)
- robots.txt(X、2026年11月3日確認)
- x.com/robots.txt(2026年10月31日の記録)(Internet Archive)
- Supporting a shared AI training control for websites(Google検索セントラル ブログ、2026年10月30日)
- Google’s common crawlers(Google、2026年11月3日確認)
- Your content, your choice: clearer preferences for training and grounding(Microsoft Bing Blogs、2026年10月30日)
- Making it easier for websites to express AI training preferences(OpenAI、2026年10月30日)
- Google, Microsoft & OpenAI Plan To Honor Shared AI Training Opt-Out(Search Engine Journal、2026年11月1日)
- robots.txt auf Diät: Ein einziger Befehl soll alle KI-Trainer stoppen(heise online、2026年11月2日)
あわせて読みたい
- Google・Microsoft・OpenAI、AI学習の拒否をrobots.txtで共通指定に 2027年にかけて対応
- Google、robots.txtに何を書けるか解説 日本語パスはパーセントエンコード推奨、解釈するのは4項目のみ
- 日本の主要サイトのAIクローラー対応とllms.txt導入率【2026年10月調査】
- Meta、商用規約のクロール条項から『学習』を削除 10月30日発効
更新履歴
- 2026年11月3日:初版