Google、Microsoft、OpenAIの3社は2026年10月30日(米国時間)、サイトのコンテンツを生成AIの学習に使ってよいかを、robots.txtの共通の書き方で伝えられる仕組みに対応すると発表した。インターネット技術の標準化団体IETFのAI Preferences(AIPREF)作業部会で議論されている案にもとづくもので、User-Agent: __usage_ai-trainingというグループを書けば、対応する複数のAI事業者に同じ意思をまとめて示せる。Googleは2027年の対応を目指し、Microsoftは2027年2月1日から反映、OpenAIは数か月以内に対応するとしている。
この記事の要点(3行)
- robots.txtに「User-Agent: __usage_ai-training」のグループを書くと、対応するAI事業者すべてに「AI学習に使ってよいか」を一度に伝えられる。Google-ExtendedやGPTBotなど、各社ごとの今の指定もそのまま使える
- Googleは、この共通の指定で学習を拒否し、Google-Extendedを個別に書いていないサイトを「Google-Extendedを拒否した」ものとして扱う。Microsoftは2027年2月1日から反映し、AIの回答の根拠に使うかを決める「AI Grounding」もページ単位で新設する
- BingでNoArchive・NoCacheを使ってAIでの利用を止めているサイトは、2027年3月1日までに新しい指定へ移す必要がある。Google-ExtendedとBingの新しい指定は、それぞれの通常の検索結果への掲載に影響しない
共通の「AI学習の可否」指定とは
もとになっているのは、IETFのAIPREF作業部会で議論されているインターネットドラフト「Machine-Readable Training Preference Signal」だ。robots.txtのUser-Agentの行に、特定のクローラー名ではなく「用途」を表すトークン(ポリシートークン)__usage_ai-trainingを書き、その下のAllow/Disallowで、どのパスをAI学習に使ってよいか・使ってほしくないかを示す。新しい命令や書式は増やさず、パスの書き方や「最も長く一致したルールが優先」といったrobots.txtの決まりはそのまま使う。
これまでは、AI学習を断りたいサイトはGoogle-Extended、GPTBotといった事業者ごとのトークンを一つずつ調べて書き分ける必要があった。共通のトークンに対応する事業者が増えれば、1つのグループで済むようになる。対象となる「AI学習」は、生成AIモデルの学習(モデルのパラメータを変えること)で、分類やランキングなど生成以外の用途にだけ使うモデルの学習は含まない。
ドラフトでは、User-Agent: *のグループはこのトークンに当てはまらないと定めている。また、このトークンのグループを書いても、各社のクローラーが自分の名前のルールでクロールしてよいかを判断する仕組みは変わらない。つまり、学習の可否と、クロールそのものの可否は別に管理することになる。
Google:共通の指定を「Google-Extendedの拒否」として扱う
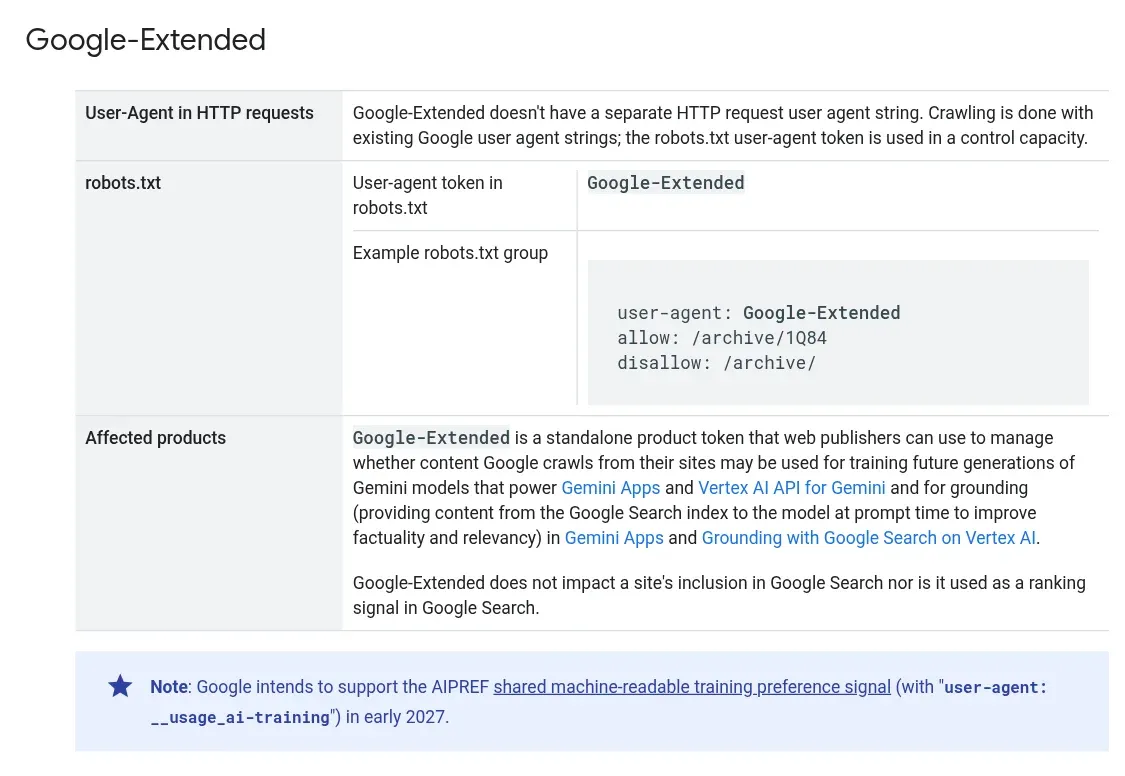
Google検索セントラルのブログによると、サイトがrobots.txtでこの共通のトークンを使って学習を拒否し、かつGoogle-Extendedを個別に指定していない場合、GoogleはそれをGoogle-Extendedを拒否したものとして扱う予定だ。Google-Extendedは、Googleが2023年から提供しているAI学習の制御用トークンで、今後のGeminiモデルの学習や、GeminiアプリとVertex AIでのグラウンディング(回答時に検索インデックスの内容を参照すること)に使うかどうかを管理できる。
各社ごとの指定は今後も共通の指定と並んで使える。共通の指定で大まかに決めたうえで、Google-ExtendedのようにGoogle向けの指定で細かく調整することもできる。Googleは、Google-Extendedを明示的に許可しているサイトは、Geminiアプリでグラウンディングを通じて回答に表示され、クリックを得られる対象になると説明している。対応時期についてブログは「2027年に、ほかのAI事業者とともに対応することを目指す」とし、Googleのクローラー一覧のGoogle-Extendedの項目には「user-agent: __usage_ai-training」による共通シグナルに2027年初めに対応する予定との注記が加わった。
Microsoft(Bing):AI学習に加えて「AI Grounding」をページ単位で指定
Microsoftは、共通のAI Training(AI学習)の指定に対応するとともに、独自のAI Groundingの指定を新しく設ける。対象はMicrosoftのクローラーが集めたWebコンテンツで、Bing、Copilot、Microsoft 365でのWebにもとづく回答も含む。どちらの指定も、Bingの通常の検索結果に載る条件は変えないとしている。
- AI Training:robots.txtでサイト全体やパス単位に指定する共通の指定。Microsoftはこれをページ単位にも広げ、ページ単位の指定はrobots.txtの指定より優先される
- AI Grounding:AIが回答を作るときの根拠として使うかどうかの、Microsoft独自のページ単位の指定。
Allow(既定)、DisallowExtended、Disallowから選ぶ。サイト全体をrobots.txtで指定する方法はない DisallowExtendedは、根拠としての利用をAI Mode、AI Overview、Copilot、Microsoft 365などMicrosoft自身が運営するサービスに限り、Web IQやFoundryのAPIを通じたグラウンディングなど、Microsoftが他社向けに提供するサービスでは使わせない設定- 何も指定しなければ、AI TrainingもAI Groundingも「Allow」として扱われる
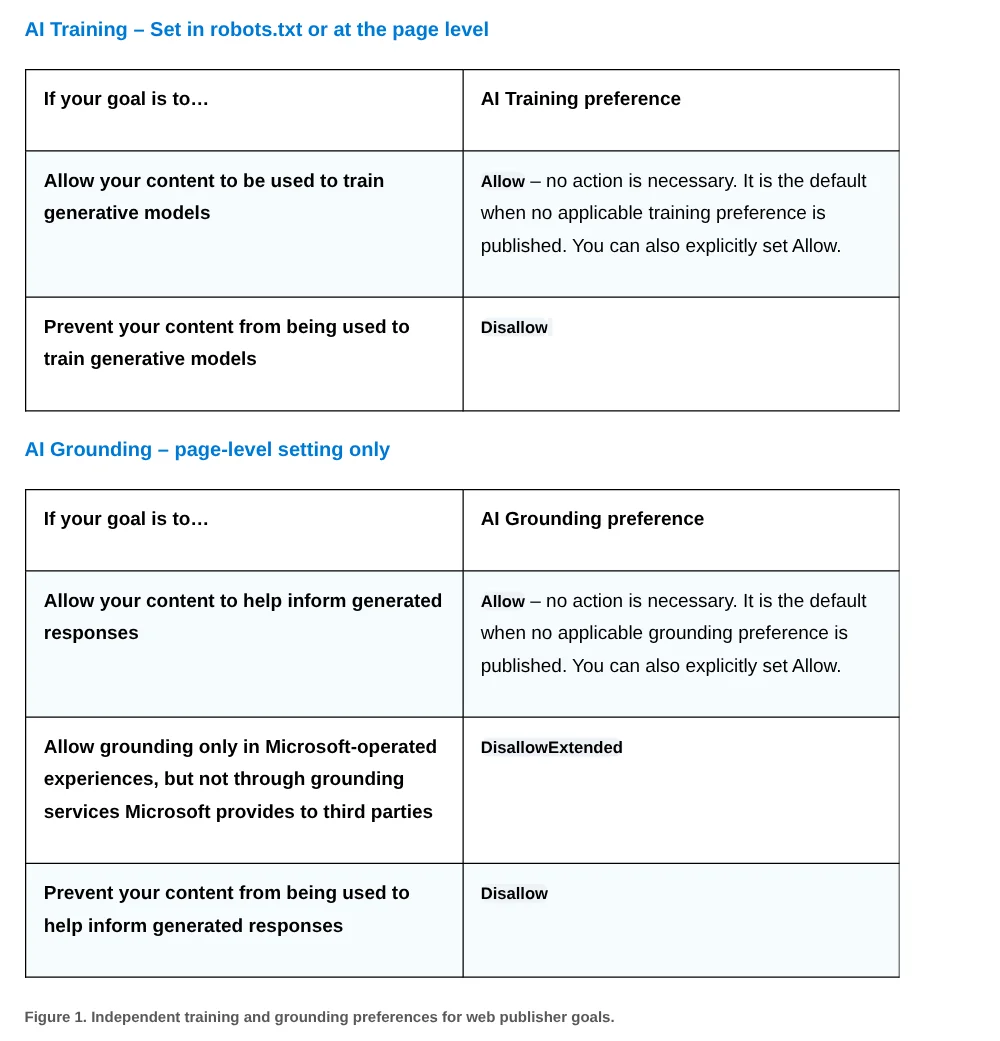
たとえば、AI TrainingをDisallow、AI GroundingをAllowにすれば、学習には使わせずに、AIの回答の根拠としては使ってもらえる状態にできる。一方でMicrosoftは、GroundingをDisallowExtendedやDisallowにすると、AIでの回答にブランドが表示される機会が大きく減ると注意している。どちらを選んでも、掲載や流入、対価が保証されるわけではない。
NoArchive・NoCacheを使っているサイトは2027年3月1日までに移行
Microsoftは2023年から、NoArchiveとNoCacheのタグでAIの学習・グラウンディングへの利用を制御できるようにしてきた。新しい指定はこれを置き換えるもので、日程は次のとおり。
| 日付 | 内容 |
|---|---|
| 2026年12月15日 | Bing Webmaster Toolsで、グラウンディングの一時的な移行設定の受け付けが始まる。対象は、この時点でNoArchiveかNoCacheを使っているサイトだけ |
| 2027年2月1日 | 新しいAI Training・AI Groundingの指定が、クロールに合わせて反映され始める |
| 2027年3月1日 | NoArchive・NoCacheで制限しているサイトの移行期限。この日以降、NoArchive・NoCacheは学習・グラウンディングの指定として読まれなくなる |
| 2027年9月30日 | Bing Webmaster Toolsの一時的な設定の期限。これより前に再クロールで新しい指定が見つかったページは、その時点で新しい指定に切り替わる |
AIの回答の根拠に使わせたくない場合は、3月1日までに①各ページにAI Groundingの指定を載せ、②Bing Webmaster Toolsで一時的な設定を登録する、の両方が必要だ。再クロールが3月1日までに来るとは限らないためで、登録しなかったページは、再クロールで新しい指定が見つかるまでグラウンディングが「Allow」扱いになる。学習については、robots.txtかページ単位でAI Trainingの指定を載せればよく、Bing Webmaster Toolsでの一時的な設定はない。新しい指定がサイトで見つかると、残っているNoArchive・NoCacheは無視される。
OpenAI:数か月以内に対応、GPTBotの設定もそのまま有効
OpenAIも同じ10月30日、robots.txtの共通シグナルに従うと発表した。対象は生成AIの基盤モデルの学習で、数か月以内に実装し、その際に実装の詳細をあらためて知らせるとしている。共通シグナルは、OpenAIが今robots.txtで提供している制御に置き換わるものではなく、既存のクローラーごとの指定も引き続き適用される。OpenAIのクローラーの説明ページでは、学習用のクロールはGPTBotが担い、GPTBotを拒否すれば生成AIの基盤モデルの学習に使ってほしくないという意思表示になる。ChatGPTの検索結果に表示するためのOAI-SearchBotは、GPTBotとは別に設定できる。
robots.txtの書き方の例
Microsoftの発表に載っている記述例は次のとおり。学習を許可するのが既定なので、許可する場合は何も書かなくてよい。
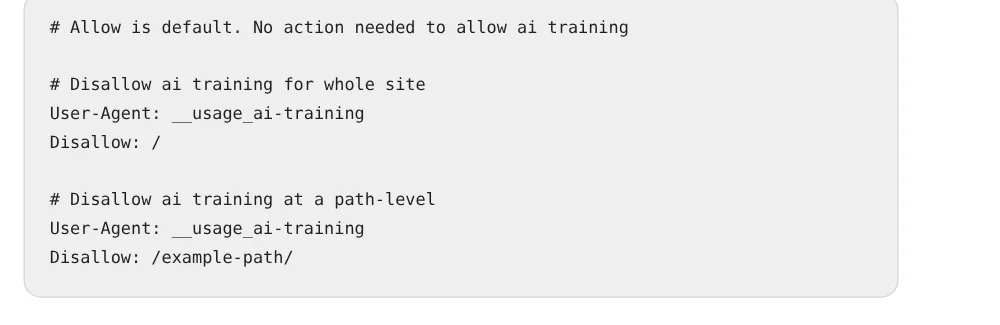
# サイト全体でAI学習を拒否する
User-Agent: __usage_ai-training
Disallow: /

# 特定のパスだけAI学習を拒否する
User-Agent: __usage_ai-training
Disallow: /example-path/
許可をあえて明示する場合の例(任意)。
User-Agent: __usage_ai-training
Allow: /
IETFのドラフトには、サイト全体で拒否しつつ一部のパスだけ許可する例も載っている。この例では、/press-kit/以下だけ学習を許可するという意味になる。
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/Bingでページ単位に指定する場合は、metaタグかHTTPレスポンスヘッダーを使う。以下はいずれも「拒否」の例で、Groundingをほかの設定にする場合はai-grounding:disallowextendedを使う。
<!-- AI学習を拒否(ページ単位) -->
<meta name="Bingbot" content="ai-training:disallow">
X-Robots-Tag: Bingbot: ai-training:disallow

<!-- AIの回答の根拠としての利用を拒否(ページ単位) -->
<meta name="Bingbot" content="ai-grounding:disallow">
X-Robots-Tag: Bingbot: ai-grounding:disallow
3社の対応のまとめ
| Microsoft(Bing) | OpenAI | ||
|---|---|---|---|
| 共通の指定への対応時期 | 2027年(クローラー一覧では2027年初め) | 2027年2月1日からクロールに合わせて反映 | 数か月以内 |
| 各社ごとの指定 | Google-Extendedも引き続き有効。Google-Extendedを個別に書いていないときに共通の指定を当てはめる | NoArchive・NoCacheは2027年3月1日以降、学習・グラウンディングの指定として読まれない | GPTBotなど既存のクローラーごとの指定も引き続き適用 |
| 独自の追加 | — | ページ単位のAI Training、AI Grounding(Allow/DisallowExtended/Disallow) | 実装時に詳細を案内予定 |
| 検索への影響 | Google-ExtendedはGoogle検索への掲載・順位に影響しない | Bingの検索結果に載る条件は変わらない | ChatGPTの検索はOAI-SearchBotで別に設定 |
サイト運営者・マーケター向けの読みどころ
- 今すぐ書き換える必要はない:各社の対応は2027年にかけて。今のGoogle-ExtendedやGPTBotの指定は引き続き有効なので、共通の指定は「追加で書いておく」ものと考えればよい
- 「User-Agent: *」ではAI学習を断ったことにならない:ドラフトは、*のグループを共通トークンに当てはめないと定めている。学習を断るなら__usage_ai-trainingを名指しで書く
- 学習と、回答での引用は分けて考える:Microsoftは学習(Training)と回答の根拠(Grounding)を別々に設定できる。AIでの露出を保ちたいなら、学習だけ拒否してGroundingは許可する選択肢がある。Googleも、Google-Extendedを許可しているサイトがGeminiアプリでのグラウンディングの対象になると説明している
- BingでNoArchive・NoCacheを使っているサイトは要対応:移行しないまま2027年3月1日を過ぎると、NoArchive・NoCacheではAIでの利用を制限できなくなる。12月15日以降にBing Webmaster Toolsで一時的な設定を登録し、各ページに新しいmetaタグかヘッダーを入れる準備をしておきたい
- robots.txtは「お願い」であり、クロールの拒否とは別:学習の可否の指定は利用のしかたへの意思表示で、クロールそのものを止めるものではない。Microsoftも、Allowの指定がBingbotのクロール拒否を上書きすることはないと説明している
注意点・補足
- もとになっているIETFの文書はまだインターネットドラフト(案)で、最終的な標準ではない。AIPREFの語彙のほかの部分は議論が続いており、今後内容が変わる可能性がある
- Googleは、この取り組みがEUのAI法にもとづく汎用AIモデル提供者向けの行動規範(GPAI Code of Practice)と整合していると説明している
- OpenAIの対応の詳細(実装時期や扱い)は、実装時にあらためて案内される予定
- 記述例は各社・IETFの公式ページに載っているものだけを掲載した。実際に設定する前に、各社の最新のドキュメントを確認してほしい
関連記事
- Google、robots.txtに何を書けるか解説 日本語パスはパーセントエンコード推奨、解釈するのは4項目のみ
- Google、検索でのコンテンツ共有の制御ガイドを更新 AI Overview・AI Mode除外なども同じページに
出典
- Google Search Central Blog — Supporting a shared AI training control for websites(2026年10月30日)
- Google Crawling Infrastructure — Google’s common crawlers
- Microsoft Bing Blogs — Your content, your choice: clearer preferences for training and grounding(2026年10月30日)
- OpenAI — Making it easier for websites to express AI training preferences(2026年10月30日)
- OpenAI — Overview of OpenAI Crawlers
- IETF — draft-kelley-aipref-training-preference-signal(Machine-Readable Training Preference Signal)