平山 大樹 AB通信 運営責任者
AB通信 編集部が、企業・行政の公式発表や決算資料などの一次情報を確認して書いています。運営会社・編集方針
目次
この記事のポイント
- Frontier Model Forum(FMF)は2026年11月5日、AIの安全対策を突破された場合のサイバー上の危険度を評価する枠組みの初版(1.0)を公開しました
- 対象は、安全対策を回避して制限された能力や情報を引き出す、再現できる手法(ジェイルブレイク)です
- 「能力の上乗せ」「能力の範囲」「使いやすさ」「見つけやすさ」の4つの観点の点数を組み合わせて評価します
- 初版で検証はこれからです。2026年12月21日まで外部の意見を募集しています
FMFは、AIを開発する企業が参加する業界団体です。発表にはAmazon Web Services、Anthropic、Google DeepMind、Microsoft、OpenAIの担当者がコメントを寄せています。OpenAIは日本時間11月7日、公式Xでこの枠組みを紹介しました。
同じ「突破」でも危険度が違うため、共通の物差しを作りました
FMFは、安全対策の突破がすべて同じリスクではないと説明しています。実際には役に立たない回答しか出ないものもあれば、攻撃者に危険なサイバー能力を与えかねないものもあります。共通の評価方法がないと、組織ごとに評価が分かれ、結果を比べにくく、危険度の低い問題の対応に限られた人手を使ってしまう、というのが作成の理由です。
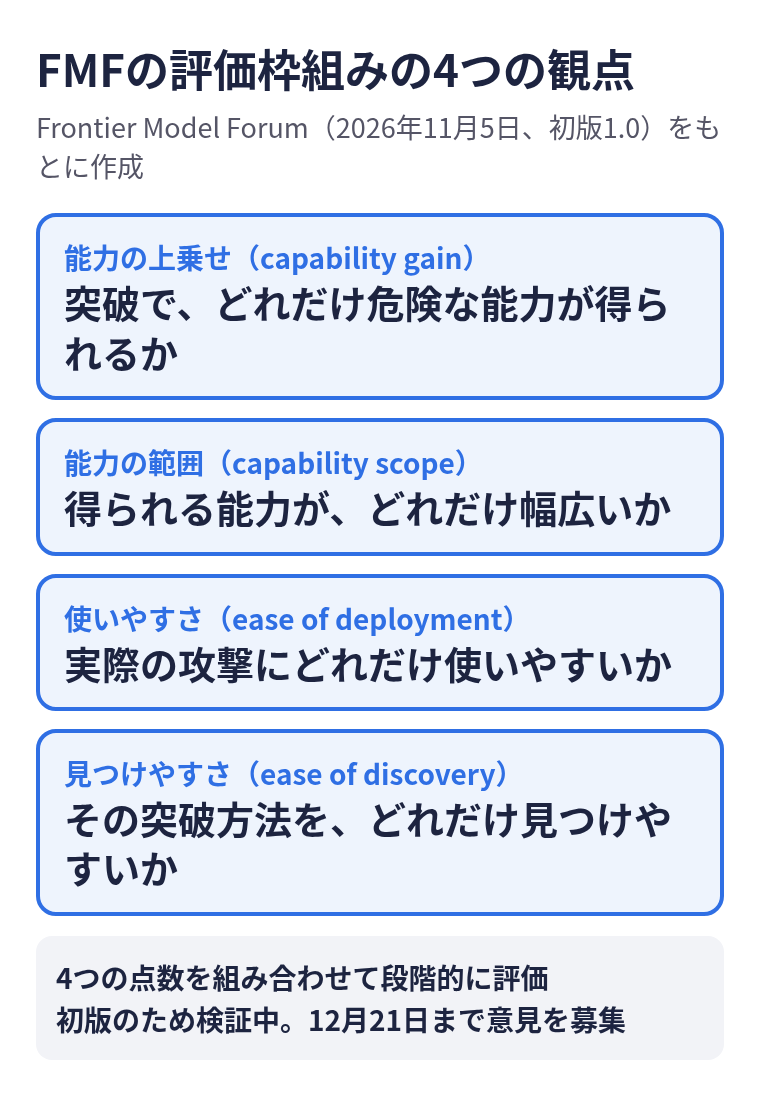
4つの観点の点数を組み合わせて危険度を段階で評価します
| 観点(英語名) | 見るポイント |
|---|---|
| 能力の上乗せ(capability gain) | 突破によって、どれだけ危険な能力が得られるか |
| 能力の範囲(capability scope) | 得られる能力が、どれだけ幅広いか |
| 使いやすさ(ease of deployment) | その能力を実際にどれだけ使いやすいか |
| 見つけやすさ(ease of discovery) | その突破方法をどれだけ見つけやすいか |
観点の訳はAB通信によるものです。評価の目的は、AI開発者やセキュリティ研究者、政策担当者が、危険度の高いものから順に対策できるようにすることです。
初版のため、評価が安定するかの検証はこれからです
- FMFは今後、さまざまなジェイルブレイクに当てはめ、評価者が違っても同じような評価になるか、評価の差が実際のリスクの差を表すかを確かめるとしている
- 新しい手法の発見や理解の深まりに合わせて更新する予定
- 意見は2026年12月21日まで受け付け、加盟企業と検討して改訂版に反映する
AIを使う企業のセキュリティ担当者にとっての意味
- AI企業が「安全対策の突破」をどう重み付けしているかを知る手がかりになる
- 社内でAIツールを評価するときも、「突破されたら何ができてしまうか」「どれだけ簡単か」で分けて考える視点は参考になる
- この枠組みは個別のAIサービスの安全性を保証するものではない
出典
- Introducing the FMF Jailbreak Rating Framework for Frontier Cyber Threats(Frontier Model Forum、2026年11月5日)
- OpenAI公式Xの紹介(2026年11月7日 4:58 JST)
更新履歴
- 2026年11月9日:初版